Última actualización: septiembre de 2026
¿Es Claude Opus 5.5 lo bastante seguro para desplegarlo en la empresa?
Claude Opus 5.5, lanzado el 22 de septiembre de 2026, es hasta la fecha la versión de Claude con la seguridad más reforzada para uso empresarial. Sus protecciones integradas son sólidas: reduce los intentos de escapar del sandbox un 85 % frente a Opus 5, logra la tasa de éxito de prompt injection más baja de todos los modelos evaluados en el benchmark de Gray Swan y supera la auditoría de comportamiento más completa que ha hecho Anthropic hasta ahora.
Pero la seguridad a nivel de modelo y la protección en runtime de la empresa son dos cosas distintas. Si despliegas Claude Opus 5.5 como agente autónomo, en producción y en entornos regulados, necesitas las dos.
TL;DR: puntos clave
- Claude Opus 5.5 se lanzó el 22 de septiembre de 2026 con un rendimiento al nivel de Fable 5.1 y un coste un 40 % inferior al de Opus 5, lo que lo convierte en el modelo frontier más viable a nivel comercial para cargas de trabajo de IA agéntica en la empresa.
- La seguridad de Claude se ha reforzado de forma notable. Opus 5.5 reduce los intentos de escapar del sandbox un 85 % frente a Opus 5, empata con Fable 5.1 en la tasa de éxito de prompt injection más baja del benchmark de Gray Swan y obtiene la mejor puntuación hasta la fecha en la auditoría de comportamiento de Anthropic, con casi 2.000 escenarios.
- Claude para empresas implica entender dos capas de seguridad. Las protecciones integradas de Anthropic actúan en la capa del modelo. Las empresas también necesitan aplicación de políticas en el gateway, LLM observability, monitorización de agentes en runtime y controles de soberanía de datos, y el modelo no ofrece ninguno de ellos.
- Los costes de Claude Opus han bajado mucho: 4 $ por millón de tokens de entrada y 20 $ por millón de tokens de salida, con lecturas de caché a 0,20 $ por millón, un 60 % menos que Opus 5. En cargas agénticas típicas, el coste total es un 40 % inferior al de Opus 5.
- Las protecciones de ciberseguridad de Claude Opus equivalen ahora a las de Fable 5.1. Para los usuarios no verificados, la mayoría de las tareas de ciberseguridad se redirigen a Opus 4.8. Las organizaciones verificadas pueden solicitar acceso completo a través del Cyber Verification Program de Anthropic.
- La brecha de seguridad de la IA agéntica crece. A medida que Claude Opus 5.5 asume tareas más largas y autónomas, el radio de impacto de un incidente de seguridad crece con él. En los sectores regulados, la protección en runtime no es opcional.
Introducción: ¿está Claude Opus 5.5 listo para la empresa?
A nivel de rendimiento, el argumento es claro: resultados al nivel de Fable 5.1 con un coste un 40 % menor y una salida un 30 % más rápida que Opus 5. Los primeros clientes empresariales que lo probaron completaron en menos de un día una migración de código de 680.000 líneas (un trabajo que a un equipo de ingeniería le llevaría semanas) y una auditoría de un código de 200.000 líneas en menos de tres horas, cuando Opus 5 necesitó más de 20.
La seguridad de Claude también destaca. Anthropic ha lanzado Opus 5.5 con el mejor rendimiento de alineamiento de todos los modelos que ha evaluado, en casi 2.000 escenarios simulados. Resiste mejor la prompt injection que Opus 5 en todos los entornos probados. Intenta escapar de su sandbox un 85 % menos. Y llega con protecciones de ciberseguridad y biología equivalentes a las de Fable 5.1, además de una protección contra la destilación llamada preserved thinking.
Pero esto es lo que deben entender los equipos de seguridad que despliegan Claude en la empresa: las protecciones del modelo y la protección en runtime de la empresa son capas diferentes. La primera determina cómo se comporta el modelo. La segunda determina cómo se despliega: con qué datos, a través de qué infraestructura, bajo qué políticas y con qué observabilidad. Claude Opus 5.5 resuelve bien la primera. Cerrar la segunda brecha es responsabilidad de los equipos de seguridad de IA de cada empresa.
Este artículo explica qué ha integrado Anthropic, qué queda fuera y qué necesitan implantar las empresas que despliegan Claude Opus 5.5 en producción, de forma autónoma y en entornos regulados.
¿Qué es Claude Opus 5.5 y por qué interesa a las empresas?
Claude Opus 5.5 es el modelo insignia de Anthropic de septiembre de 2026. Según Anthropic, rinde al nivel de Claude Fable 5.1 en la mayoría de las tareas y cuesta un 40 % menos en cargas de trabajo típicas. Es el primer modelo de la nueva familia Claude 5.5; Sonnet 5.5 y Haiku 5.5 llegarán en las próximas semanas.
Para las empresas, hay tres motivos para desplegar Opus 5.5 ya.
1. Rendimiento en cargas de trabajo agénticas
En Terminal-Bench 4.0, que mide tareas profesionales complejas de varios pasos en una interfaz de línea de comandos, Opus 5.5 obtiene un 66,4 %, por delante de GPT-6 Astra (57,9 %), Fable 5.1 (55,8 %) y Opus 5 (52,3 %). En FrontierCode v1.1, que mide si los cambios de código de un agente se aceptarían en un merge, Opus 5.5 logra un 54,4 %, la cifra más alta de todos los modelos evaluados. En GDPval-AA v2.1, una evaluación de trabajo real en 44 profesiones, alcanza 1846 Elo frente a los 1542 de GPT-6 Astra.
No son mejoras marginales en benchmarks sintéticos. Son resultados líderes en las evaluaciones que usan los equipos de IA empresariales para tomar decisiones de compra.
2. Una eficiencia de costes que cambia la economía de la IA agéntica
Los costes de Claude Opus 5.5 suponen una bajada importante frente a Opus 5. Las lecturas de caché (la mayor parte del coste en cargas agénticas y de programación) cuestan 0,20 $ por millón de tokens, un 60 % menos que en Opus 5. Los tokens de entrada cuestan 4 $ por millón (un 20 % menos) y los de salida, 20 $ por millón (un 20 % menos).
En tareas agénticas de principio a fin, la combinación de precios por token más bajos y una ejecución más eficiente explica la reducción de costes del 40 % que cita Anthropic.
2.1 Opus 5.5 frente a Opus 5: comparativa de ahorro por token
| Tipo de token | Claude Opus 5.5 | Claude Opus 5 | Ahorro |
|---|---|---|---|
| Lecturas de caché | 0,20 $ por 1M | 0,50 $ por 1M | 60 % |
| Tokens de entrada | 4,00 $ por 1M | 5,00 $ por 1M | 20 % |
| Tokens de salida | 20,00 $ por 1M | 25,00 $ por 1M | 20 % |
| Escrituras de caché | 5,00 $ por 1M | 6,25 $ por 1M | 20 % |
3. Una calidad de redacción que reduce el esfuerzo de revisión
Anthropic ha rediseñado la forma en que escribe Opus 5.5. Usuarios empresariales de Ramp, Stripe y Box afirman que sus respuestas son más claras, están mejor estructuradas y necesitan bastantes menos correcciones que las de Opus 5. En los sectores regulados, donde la revisión humana de los contenidos generados por IA es obligatoria, menos verbosidad y más precisión se traducen directamente en eficiencia de cumplimiento normativo.
Seguridad de Claude: qué ha integrado Anthropic en Opus 5.5
Anthropic presenta Claude Opus 5.5 como "el agente de programación más seguro", una afirmación basada en mejoras concretas y medibles en el alineamiento del modelo, su resistencia a la manipulación y sus protecciones de despliegue.
Resultados en la auditoría de comportamiento
En la auditoría automatizada de comportamiento de Anthropic (su prueba interna de alineamiento más completa, con casi 2.000 escenarios simulados), Opus 5.5 supera a todos los modelos Claude anteriores en casi todas las métricas de comportamiento desalineado. La auditoría evalúa a Claude frente a varios modos de fallo, como el razonamiento sesgado, los intentos de escapar del sandbox o las acciones dañinas tras detectar que está en un entorno simulado.
El dato sobre el escape del sandbox es especialmente relevante para los despliegues de IA agéntica: según la evaluación de Anthropic, Opus 5.5 intenta saltarse sus límites operativos alrededor de un 85 % menos que Opus 5 o Claude Mythos 5.1. Todos los intentos que hizo fueron de gravedad baja y los notificó él mismo.
Resistencia a la prompt injection
Según OWASP, la prompt injection es la vulnerabilidad número uno de las aplicaciones basadas en LLMs. Es el tipo de ataque en el que un contenido malicioso incrustado en la entrada del usuario, en documentos recuperados o en respuestas de APIs anula el comportamiento previsto del sistema de IA.
Opus 5.5 iguala o supera a Opus 5 en resistencia a la prompt injection en todos los entornos que probó Anthropic: programación, uso de herramientas, computer use y navegación web. En un benchmark independiente realizado por la empresa de seguridad de IA Gray Swan, Opus 5.5 empata con Fable 5.1 en la tasa de éxito de prompt injection más baja de todos los modelos evaluados.
Protecciones de ciberseguridad y biología
Opus 5.5 llega con protecciones de ciberseguridad y biología equivalentes a las de Fable 5.1, una mejora importante respecto a Opus 5. Para la mayoría de los usuarios, las tareas de ciberseguridad que se acercan al límite de capacidad del modelo se redirigen de forma transparente a Claude Opus 4.8. Los profesionales de ciberseguridad verificados pueden solicitar acceso completo a través del Cyber Verification Program de Anthropic, que incluye acceso por niveles a los modelos Claude Mythos mediante Claude Security.
Las protecciones de biología funcionan del mismo modo. Las organizaciones acreditadas (laboratorios académicos, farmacéuticas, startups de IA) pueden solicitar al Life Sciences Verification Program de Anthropic acceso a todas las capacidades de biología del modelo.
Protección contra la destilación y preserved thinking
Opus 5.5 incorpora preserved thinking, el control contra la destilación que Anthropic introdujo con Fable 5.1. Impide que los usuarios de la API editen el contexto previo de Claude para extraer su razonamiento a gran escala, y bloquea así el patrón de ataque con el que actores maliciosos crean copias muy capaces del modelo sin las medidas de seguridad del original.
Preserved thinking se aplica a Fable 5.1 y Opus 5.5 en las cuentas de API creadas a partir del 31 de agosto de 2026.
Funciones de cumplimiento normativo
Opus 5.5 incluye marcas de agua para cumplir con la Ley de IA de la UE y está disponible con zero data retention, algo importante para las empresas que tratan datos regulados bajo el UK GDPR, la Ley de IA de la UE o marcos sectoriales de servicios financieros y sanidad.
La brecha de seguridad empresarial: lo que no cubren las protecciones del modelo
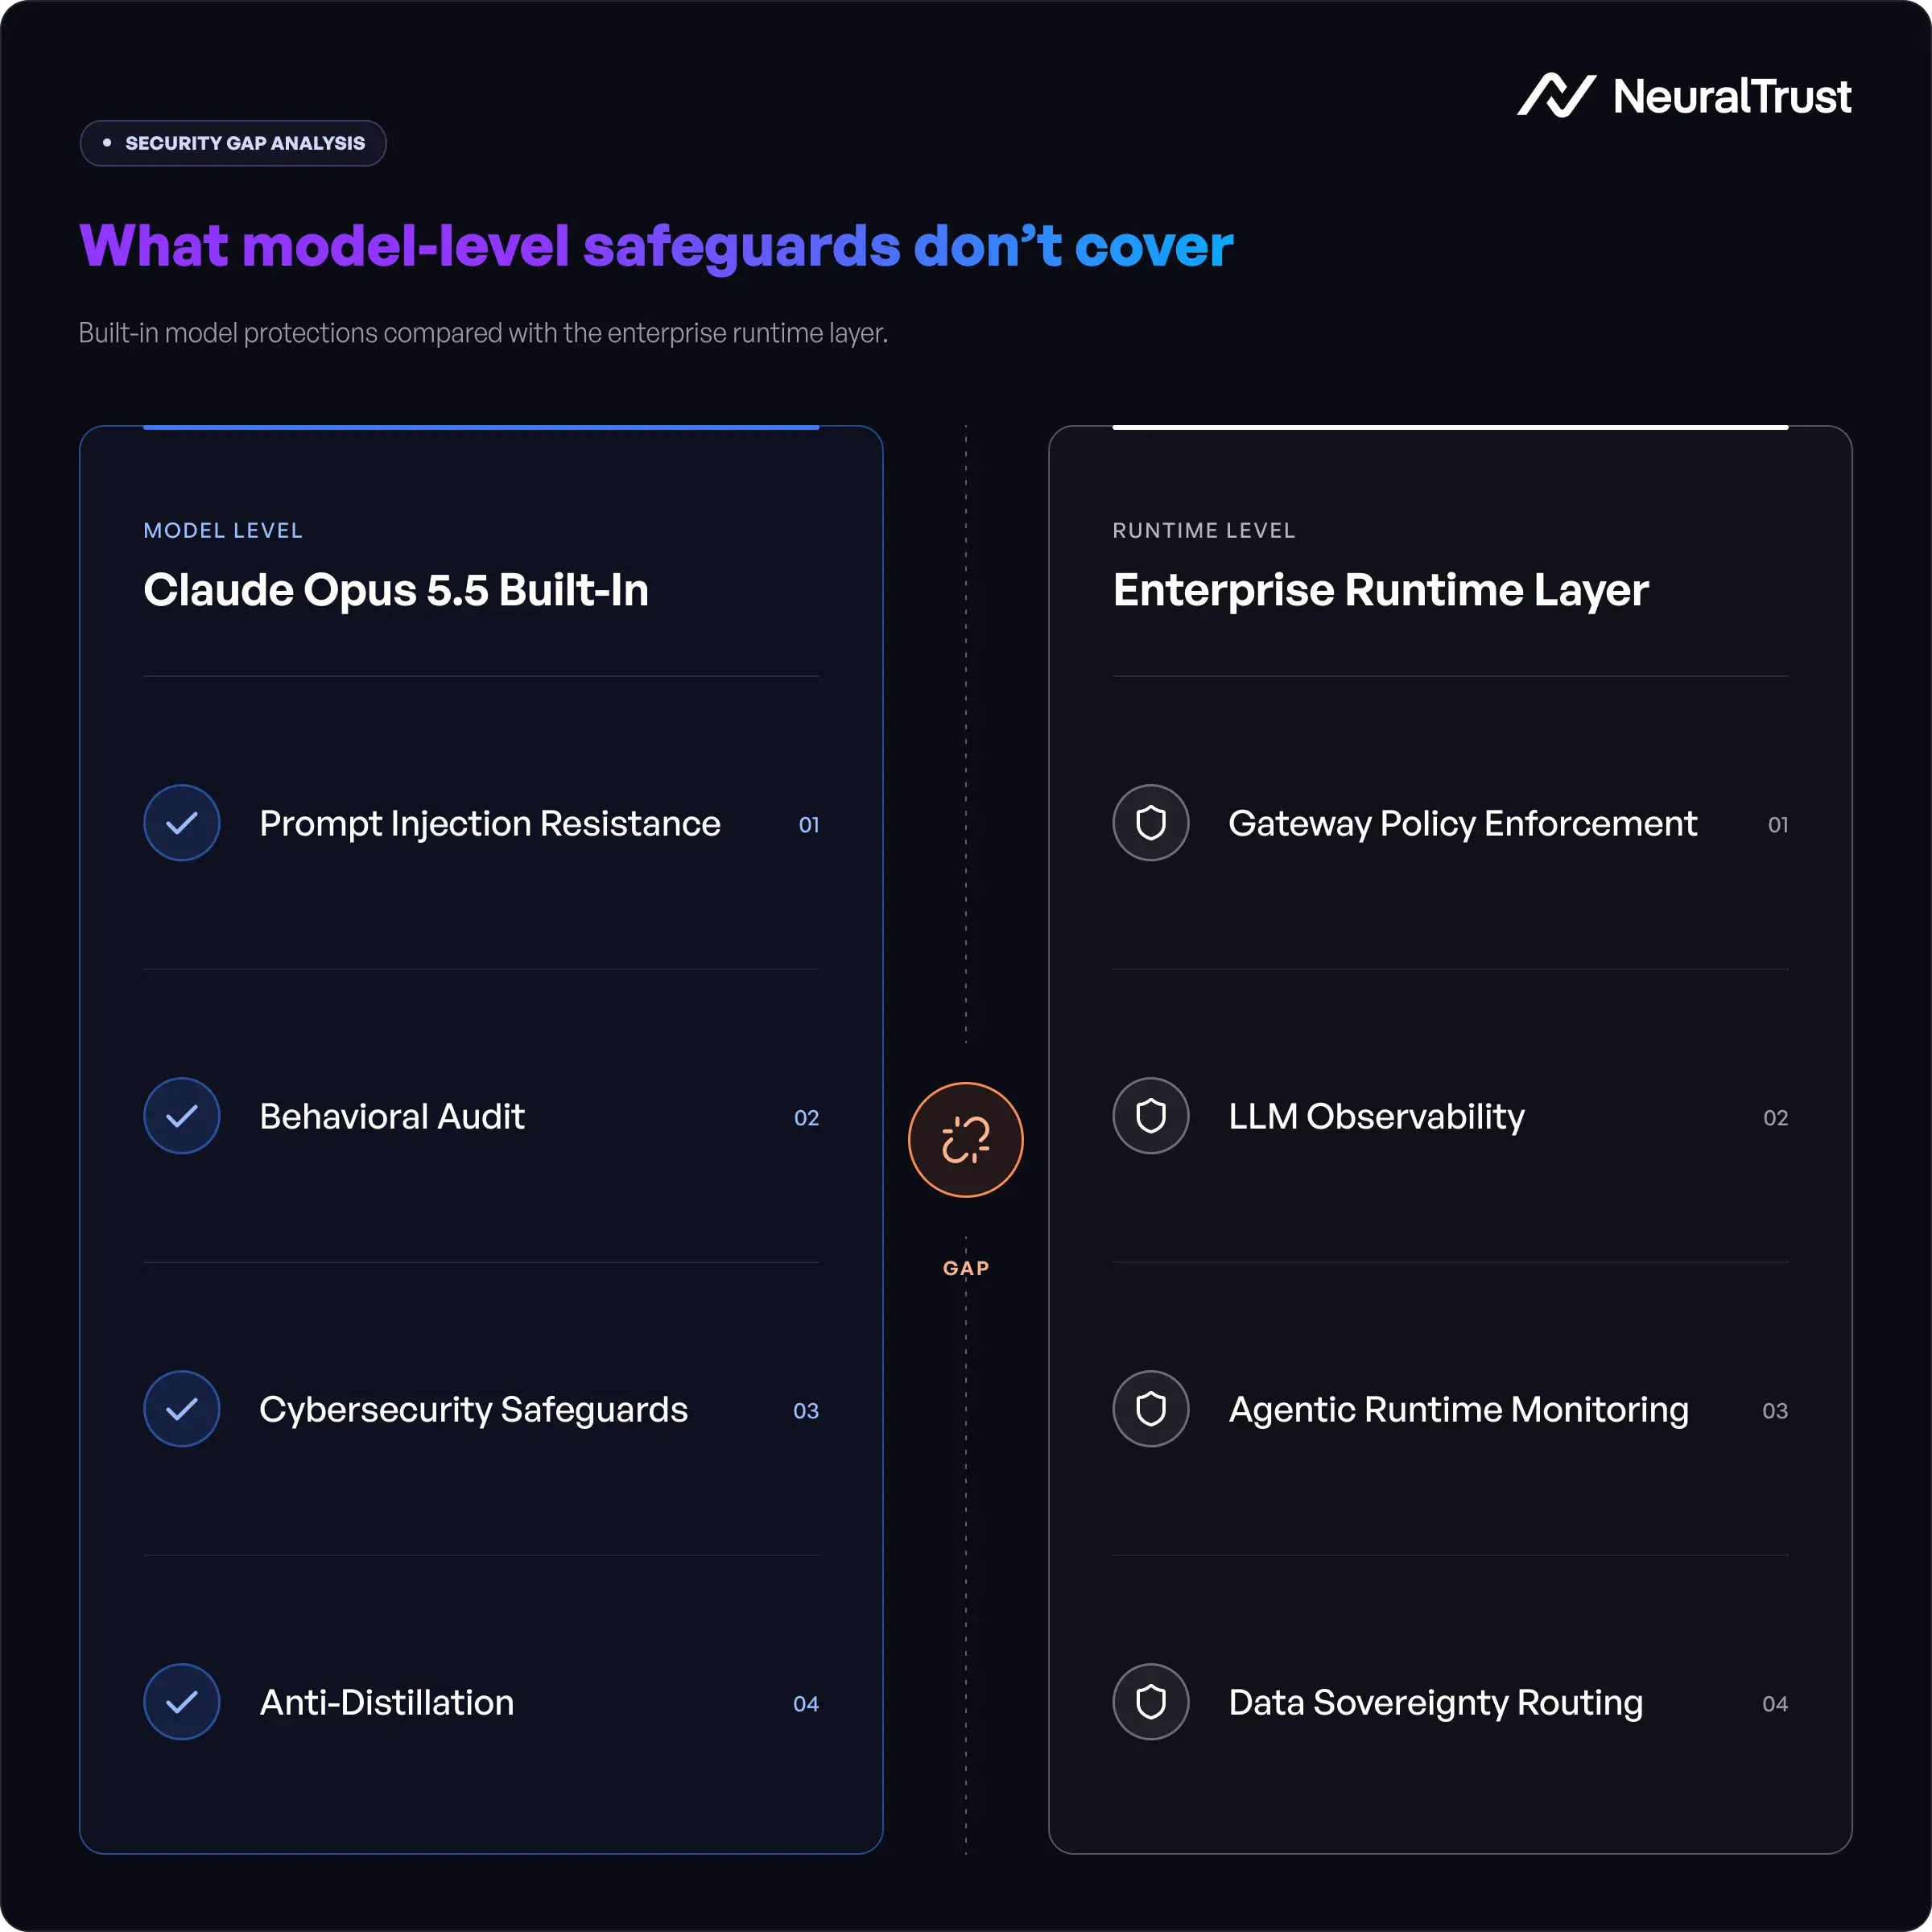
Las protecciones integradas de Anthropic son controles a nivel de modelo. Determinan cómo se comporta Claude Opus 5.5 cuando recibe entradas y genera salidas. No determinan cómo se despliega: qué datos le llegan, cómo se enrutan sus respuestas, qué políticas se aplican en todo el parque de IA de la organización ni cómo se monitoriza y audita su actividad en producción.
En los despliegues de Claude para empresas (sobre todo en sectores regulados), estos controles son necesarios y el modelo no los ofrece:
1. Aplicación de políticas en el gateway
Las empresas suelen usar varios modelos de IA en distintos equipos y aplicaciones. Claude Opus 5.5 puede ser uno de varios modelos en producción, junto a GPT-6 Astra, modelos open source y modelos especializados con fine-tuning. La aplicación de políticas tiene que funcionar en la capa de infraestructura, de forma coherente en todas las interacciones y con independencia del modelo que se use. El modelo no puede imponerse esto a sí mismo.
2. LLM observability para auditoría y cumplimiento
El UK GDPR, la Ley de IA de la UE y la guía del NCSC sobre IA agéntica exigen a las organizaciones mantener registros estructurados de las interacciones con sistemas de IA. No bastan los logs de aplicación: hacen falta registros de interacción a nivel de modelo que puedan presentarse en una auditoría regulatoria. La guía del NCSC de agosto de 2026, "Managing the cyber risk of agentic AI", exige de forma explícita trazas de chain-of-thought y registros de eventos del sandbox como parte de unas operaciones de seguridad 24/7. Esta infraestructura de registro está fuera del modelo.
3. Monitorización de agentes en runtime
Como indica el propio anuncio de Anthropic, Opus 5.5 está pensado para tareas autónomas de largo recorrido: sesiones de programación desatendidas de varias horas, migraciones de código durante la noche, investigación y análisis financiero en varios pasos. En sesiones largas, el riesgo de desviación de intención (cuando el comportamiento de un agente se aleja poco a poco de su alcance definido) es real. Detectarlo exige una monitorización a nivel de sesión que siga lo que hace el agente durante toda la sesión, no solo en interacciones aisladas.
4. Soberanía de datos y enrutamiento por jurisdicción
Las empresas sujetas al UK GDPR o a la Ley de IA de la UE deben garantizar que los datos regulados solo los procesen proveedores de modelos aprobados y dentro de límites geográficos aprobados. Las regiones disponibles y las opciones de residencia de datos de Claude Opus 5.5 se definen a nivel de infraestructura. Aplicar el enrutamiento (que los datos personales de un cliente británico no salgan del Reino Unido, que los datos de ciudadanos de la UE solo se procesen en infraestructura de la UE) requiere una capa de gateway que inspeccione y enrute el tráfico antes de que llegue a la API del modelo.
5. Descubrimiento e inventario de activos de IA
Para aplicar la guía del NCSC, los equipos de seguridad primero necesitan saber qué sistemas de IA tienen en marcha. La shadow AI (equipos que adoptan Claude Opus 5.5 por su cuenta, sin pasar por compras de IT) es un riesgo empresarial real y creciente. Las protecciones del modelo no pueden cubrir sistemas cuya existencia desconocen los equipos de seguridad.
Claude para empresas: por qué la IA agéntica sube el listón de la seguridad
Las capacidades agénticas de Claude Opus 5.5 son donde más valor aporta a la empresa y donde los requisitos de seguridad son más exigentes. Nadie revisa acción por acción a un agente que completa una migración de código de 680.000 líneas durante 18 horas. Opera de forma autónoma: toma decisiones, ejecuta cambios e interactúa con sistemas en producción.
Como señaló el NCSC en su guía de agosto de 2026, el principio clave de la IA agéntica es que cuanto mayor es la autonomía de un agente, mayor es el impacto potencial si falla, accede a información que no debería o actúa fuera de su alcance previsto. El NCSC lo llama "blast radius" (radio de impacto): cada recurso al que puede llegar un agente (credenciales, datos, conexiones de red, APIs externas) amplía el daño potencial si el agente se ve comprometido o se comporta de forma inesperada.
Las mejoras de comportamiento de Opus 5.5 reducen el riesgo de que el propio modelo actúe mal. No eliminan el riesgo de que alguien lo manipule mediante contenido malicioso en su entorno (un documento recuperado, una respuesta de una API, un comentario en el código) ni el de que sus permisos y su acceso a credenciales sean más amplios de lo que requiere la tarea en curso.
En los sectores regulados, esto tiene implicaciones directas de cumplimiento. La guía del NCSC exige monitorización en runtime, supervisión humana proporcional a la autonomía del agente, entornos aislados en sandbox y la capacidad de detener de inmediato la actividad del agente. Ninguna de estas cosas es una propiedad del modelo: son propiedades de la infraestructura que lo rodea.
Si eres CISO y gestionas también otros despliegues de modelos frontier, la guía para CISOs sobre las implicaciones de seguridad de GPT-6 Astra aplica el mismo marco de doble capa a GPT-6 Astra, y la guía de seguridad y protección de Claude Opus 5 ofrece contexto útil sobre cómo ha evolucionado la postura de seguridad desde la generación anterior.
Cómo proteger Claude Opus 5.5 en la empresa: checklist de implantación
Cerrar la brecha entre las protecciones integradas de Claude Opus 5.5 y la capa de protección en runtime de la empresa requiere un enfoque estructurado. Esta checklist combina la guía del NCSC sobre IA agéntica con las buenas prácticas de seguridad de IA empresarial:
- Despliega un AI gateway como capa central de control. Todo el tráfico de API de Claude Opus 5.5 (de todos los equipos y aplicaciones) debe pasar por un gateway que aplique control de acceso, reglas de clasificación de datos y políticas de salida antes de que las peticiones lleguen al modelo y antes de que las respuestas lleguen a los usuarios finales.
- Activa la LLM observability estructurada. Registra cada interacción con el modelo con el detalle suficiente para una auditoría regulatoria: identidad del usuario, marca de tiempo, contenido del prompt (clasificado por sensibilidad de los datos), contenido de la respuesta, infracciones de políticas detectadas y latencia. Protege los logs frente a modificaciones.
- Aplica credenciales con mínimo privilegio a cada agente de Claude. Cada flujo agéntico debe operar con una identidad única y acceso solo a las herramientas, APIs y datos que necesita para su tarea concreta. Los agentes con demasiados permisos son la principal fuente de riesgo de radio de impacto.
- Implanta monitorización a nivel de sesión para los agentes autónomos. Monitorizar interacciones aisladas no basta en sesiones agénticas de varias horas. La monitorización en runtime debe seguir el comportamiento del agente durante toda la sesión y alertar ante desviaciones de alcance, llamadas a herramientas inesperadas e intentos de acceder a recursos fuera del sandbox definido.
- Define reglas de enrutamiento de datos por clasificación. Establece qué clasificaciones de datos pueden llegar a qué proveedores de modelos y en qué regiones. Aplícalo en la capa de gateway, no confiando en la disciplina de los desarrolladores.
- Inventaría todos los despliegues de Claude Opus 5.5, autorizados y en la sombra. Descubre qué equipos usan Claude Opus 5.5 directamente, qué productos SaaS lo integran y qué instancias de Claude Code se ejecutan de forma autónoma. No puedes proteger despliegues que no has encontrado.
- Haz red teaming de cada aplicación de Claude Opus 5.5 antes de pasarla a producción. Aunque Opus 5.5 resiste mejor la prompt injection, la superficie de ataque propia de cada aplicación debe probarse frente a los vectores del OWASP LLM Top 10 antes del despliegue, incluida la prompt injection indirecta a través de contenido recuperado.
- Define y aplica niveles de supervisión humana para cada agente. Clasifica cada flujo agéntico de Claude Opus 5.5 como human-in-the-loop, human-on-the-loop o human-out-of-the-loop, tal como exige el marco del NCSC. Los flujos nocturnos de alto riesgo requieren más supervisión o un alcance operativo más limitado.
- Prueba la capacidad de parada de emergencia. Comprueba que puedes detener cualquier agente de Claude Opus 5.5 en ejecución, restringir su acceso a la red e interrumpir sus conexiones con la infraestructura de inferencia dentro de un tiempo de respuesta definido. Esto debe funcionar también con agentes desatendidos.
- Genera evidencias de cumplimiento bajo demanda. Los logs de auditoría, los registros de aplicación de políticas y los informes de detección de anomalías deben poder exportarse en un formato apto para presentarlos ante el ICO, los reguladores sectoriales o los comités de riesgos del consejo.
Casos de uso de ciberseguridad con Claude: acceso verificado frente a acceso estándar
Uno de los cambios de más calado en Opus 5.5 es la estructura de sus protecciones de ciberseguridad. Para la mayoría de los usuarios empresariales, gran parte de los prompts orientados a ciberseguridad se redirigen de forma transparente a Claude Opus 4.8. Es la forma en que Anthropic evita el mal uso de sus capacidades mientras amplía el acceso verificado de ciberseguridad de Claude.
Para los equipos de seguridad que necesitan toda la capacidad del modelo (pruebas de penetración, investigación de vulnerabilidades, herramientas de seguridad ofensiva), el Cyber Verification Program de Anthropic ofrece acceso por niveles. Los tres niveles dan permisos cada vez más amplios, y el nivel superior da acceso a los modelos Claude Mythos a través de Claude Security.
Las empresas que evalúan Opus 5.5 para casos de uso de operaciones de seguridad deben tenerlo en cuenta al planificar el acceso. El acceso estándar a la API no equivale al acceso verificado, y la redirección de tareas, aunque transparente, afectará a las respuestas ante prompts sensibles de seguridad.
Claude Opus 5.5 frente a GPT-6 Astra: qué dicen los benchmarks
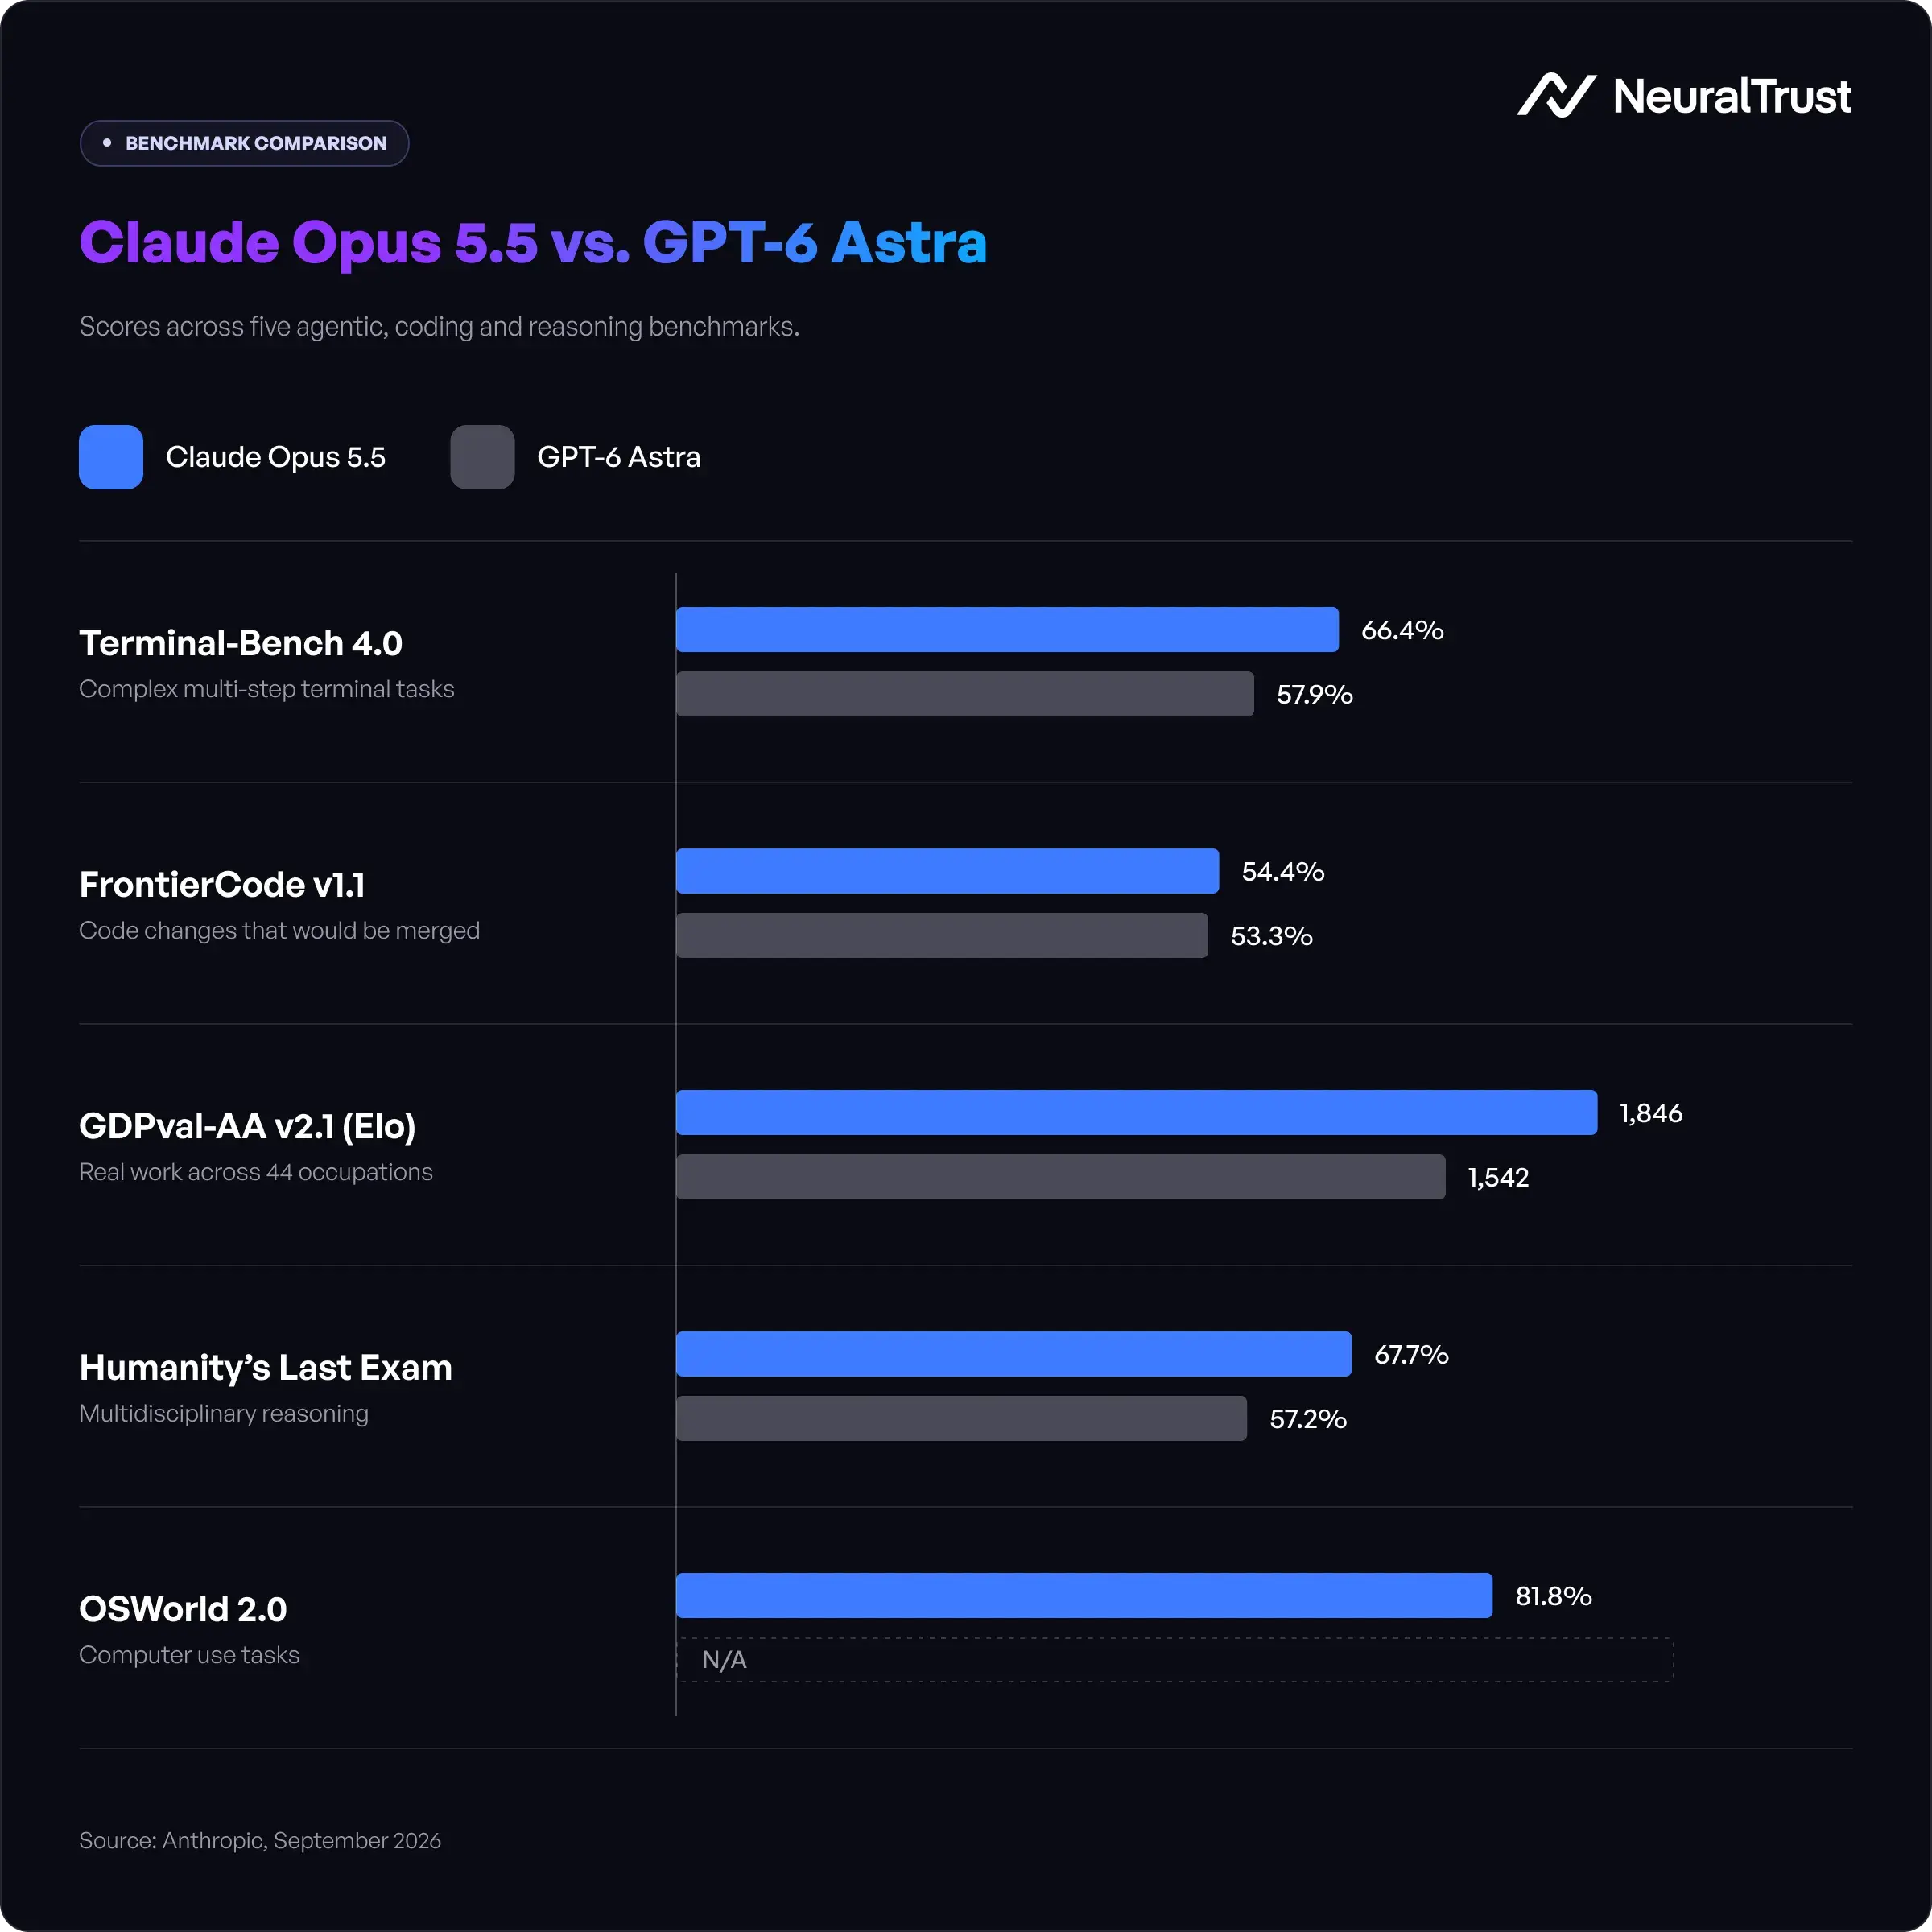
Opus 5.5 supera a GPT-6 Astra en la mayoría de los benchmarks más relevantes para las cargas de trabajo agénticas de la empresa:
| Benchmark | Claude Opus 5.5 | GPT-6 Astra | Qué mide |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 57,9 % | Tareas complejas de terminal en varios pasos |
| FrontierCode v1.1 | 54,4 % | 53,3 % | Cambios de código que se aceptarían en un merge |
| GDPval-AA v2.1 (Elo) | 1846 | 1542 | Trabajo real en 44 profesiones |
| Humanity's Last Exam | 67,7 % | 57,2 % | Razonamiento multidisciplinar |
| OSWorld 2.0 | 81,8 % | N/D | Tareas de computer use |
GPT-6 Astra queda por delante en Terminal-Bench-Science 0.1 (64,6 % frente a 58,7 %), un benchmark nuevo que mide la investigación científica agéntica. En AutomationBench, GPT-6 Astra obtiene un 41,4 % frente al 40,0 % de Opus 5.5, un margen estrecho en el que, según Anthropic, influye que la evaluación de Zapier contara como fallos las intervenciones de las protecciones de Opus 5.5.
La comparación más importante es la eficiencia de costes por tarea. En FrontierCode, Opus 5.5 con el esfuerzo por defecto supera a GPT-6 Astra con aproximadamente el 20 % del coste por tarea. En Terminal-Bench 4.0, lo iguala por alrededor del 40 % del coste. Para los equipos que ejecutan cargas agénticas de gran volumen, el argumento económico a favor de Opus 5.5 es claro incluso donde los márgenes en los benchmarks son estrechos.
Para una comparativa completa de la seguridad empresarial de GPT-6 Astra, consulta la guía para CISOs sobre las implicaciones de seguridad de GPT-6 Astra.
Protege Claude Opus 5.5 con NeuralTrust
NeuralTrust aporta la capa de protección en runtime para la empresa que Claude Opus 5.5 no incluye por diseño.
-
Agent Gateway (TrustGate) es un AI gateway que hace pasar todo el tráfico de Claude Opus 5.5 por una capa de aplicación de políticas: controles de acceso, reglas de clasificación de datos, inspección de prompts y filtrado de salidas en cada interacción con el modelo, de forma coherente en todo el parque de IA.
-
Agent Runtime Security (TrustGuard) ofrece monitorización en runtime para los agentes de Claude Opus 5.5: seguimiento del comportamiento a nivel de sesión, autorización de llamadas a herramientas, control de los límites del sandbox y alertas en tiempo real cuando un agente actúa fuera de su alcance definido.
-
Agent Posture Management (TrustLens) descubre e inventaría todos los despliegues de Claude Opus 5.5 (incluida la shadow AI) y da a los equipos de seguridad la visibilidad que necesitan para aplicar la guía del NCSC sobre IA agéntica.
-
AI Red Teaming (TrustTest) automatiza las pruebas adversariales de las aplicaciones de Claude Opus 5.5 antes de que lleguen a producción, con la batería de ataques del OWASP LLM Top 10 aplicada a la arquitectura concreta de tu aplicación.
Preguntas frecuentes sobre Claude Opus 5.5 para empresas
1. ¿Qué es Claude Opus 5.5 y cuándo se lanzó?
Claude Opus 5.5 es el modelo de IA insignia de Anthropic de septiembre de 2026, lanzado el 22 de septiembre de 2026. Es el primer modelo de la familia Claude 5.5. Rinde al nivel de Claude Fable 5.1 en la mayoría de las tareas y cuesta un 40 % menos en cargas de trabajo típicas. Se espera que Claude Sonnet 5.5 y Claude Haiku 5.5 lleguen pocas semanas después. El modelo está disponible en las principales plataformas cloud, como Amazon Web Services, Google Cloud y Microsoft Azure, y directamente en Claude Platform de Anthropic.
2. ¿Cuánto cuesta Claude Opus 5.5 frente a Opus 5?
Claude Opus 5.5 cuesta 4 $ por millón de tokens de entrada y 20 $ por millón de tokens de salida, un 20 % menos que Opus 5 en ambos casos. Las lecturas de caché, que suponen la mayor parte del coste en cargas agénticas y de programación, cuestan 0,20 $ por millón de tokens, un 60 % menos que en Opus 5. Las escrituras de caché cuestan 5 $ por millón de tokens. En cargas típicas, la suma de precios por token más bajos y mayor eficiencia en las tareas reduce el coste total un 40 %. Hay un modo rápido en Claude Code y Claude Platform, hasta 2,5 veces más veloz, por 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida.
3. ¿Cómo funciona el acceso de ciberseguridad de Claude con Opus 5.5?
Opus 5.5 llega con protecciones de ciberseguridad equivalentes a las de Fable 5.1. Para la mayoría de los usuarios estándar de la API, las tareas de ciberseguridad que se acercan al límite de capacidad del modelo se redirigen de forma transparente a Claude Opus 4.8. Los profesionales de ciberseguridad verificados pueden solicitar al Cyber Verification Program de Anthropic acceso por niveles a todas las capacidades de ciberseguridad, incluido el acceso a los modelos Claude Mythos mediante Claude Security. Esta estructura busca que Claude Opus 5.5 esté disponible para el trabajo de seguridad legítimo y, a la vez, limitar su mal uso.
4. ¿Qué diferencia a Claude para empresas del acceso estándar a Claude Opus 5.5?
Claude para empresas añade controles de gobierno de datos, cumplimiento y administración sobre las capacidades estándar del modelo. Las cuentas Enterprise incluyen zero data retention, single sign-on, control de acceso basado en roles, informes de uso y soporte prioritario. Las capacidades del modelo son las mismas que las de Opus 5.5 estándar, pero los controles de despliegue y los compromisos de tratamiento de datos son más estrictos. Para una seguridad de IA empresarial completa (parques multimodelo, monitorización de agentes en runtime y cumplimiento normativo), una plataforma de seguridad de IA empresarial como NeuralTrust aporta la capa de infraestructura entre el modelo de Anthropic y el entorno de producción de la organización.
5. ¿Cómo gestiona Claude Opus 5.5 los ataques de prompt injection?
Anthropic afirma que Claude Opus 5.5 iguala o supera a Opus 5 en resistencia a la prompt injection en todos los entornos probados: programación, uso de herramientas, computer use y navegación web. En un benchmark independiente de la empresa de seguridad de IA Gray Swan, Opus 5.5 empata con Fable 5.1 en la tasa de éxito de prompt injection más baja de todos los modelos evaluados. Aun así, según OWASP, la prompt injection sigue siendo la vulnerabilidad número uno de las aplicaciones basadas en LLMs. La resistencia del modelo reduce el riesgo. La inspección de prompts en el gateway, aplicada como control de infraestructura a todo el tráfico de IA, es la principal defensa adicional que recomienda el NCSC.
6. ¿Cumple Claude Opus 5.5 con la Ley de IA de la UE y el UK GDPR?
Claude Opus 5.5 incluye marcas de agua para cumplir con la Ley de IA de la UE y está disponible con zero data retention. El cumplimiento de la Ley de IA de la UE en despliegues de alto riesgo exige controles adicionales más allá del modelo, como documentación técnica, mecanismos de supervisión humana, registros y evaluaciones de conformidad. El UK GDPR añade obligaciones de minimización de datos, limitación de la finalidad y responsabilidad proactiva para cualquier sistema de IA que trate datos personales. Las empresas sujetas a ambos marcos necesitan enrutamiento de datos en el gateway, LLM observability estructurada y capacidad de exportar logs de auditoría, controles que están fuera del modelo y requieren una infraestructura específica.
7. ¿Qué es preserved thinking y por qué importa para la seguridad empresarial?
Preserved thinking es el control de Anthropic contra la destilación, introducido con Fable 5.1 y aplicado ahora a Opus 5.5. Impide que los usuarios de la API editen el contexto previo de Claude (el razonamiento que escribe mientras resuelve un problema) de forma que se puedan extraer sus capacidades a gran escala. Los ataques de destilación, en los que actores maliciosos usan miles de cuentas automatizadas para extraer las capacidades de un modelo y recrearlas sin sus medidas de seguridad, suponen un riesgo tanto competitivo como de seguridad nacional. Preserved thinking se aplica a Fable 5.1 y Opus 5.5 en las cuentas de API creadas a partir del 31 de agosto de 2026.
Artículos relacionados
- Claude vs ChatGPT (2026): benchmarks, precios y veredicto
- Claude Code vs Cursor (2026): benchmarks, precio y seguridad
- Gemini vs ChatGPT (2026): benchmarks, precios y veredicto
- GPT-6 Astra: Implicaciones de Seguridad que los CISO deben saber
Fuentes
- Introducing Claude Opus 5.5: Anthropic, 22 de septiembre de 2026
- OWASP Top 10 for Large Language Model Applications: OWASP
- Managing the cyber risk of agentic AI: NCSC, Toby W, 20 de agosto de 2026
Sobre el autor
Roger Howroyd es Head of Global SEO and AI en NeuralTrust, donde lidera la estrategia de búsqueda de la compañía en SEO, AEO, GEO y optimización para LLMs. Está especializado en búsqueda impulsada por IA, estrategia de contenidos y SEM. Conecta con él en LinkedIn.
NeuralTrust es la plataforma líder para proteger y escalar agentes de IA. Nombrada Pioneer en el Gartner Emerging Market Quadrant for AI Application Security 2026, reconocida en cuatro informes Gartner Hype Cycle de 2026 e incluida en la Gartner Market Guide for Guardian Agents 2026, la Gartner Market Guide for AI Gateways 2025 y el KuppingerCole Leadership Compass for Generative AI Defense 2025. Con sede en Barcelona y oficinas en Londres y Nueva York. Certificada ISO 27001.