Última actualización: 19 de noviembre, 2026
¿Qué es Gemini 4 Neon? Gemini 4 Neon es el modelo de tamaño intermedio de la familia Gemini 4 de Google, lanzado el 18 de noviembre de 2026. Se sitúa entre Gemini 4 Carbon y Gemini 4 Hydrogen y tiene una ventana de contexto de 1 millón de tokens. Cuesta 3 $ por millón de tokens de entrada y 15 $ por millón de tokens de salida. Google asegura resultados de nivel frontier en código, agentes y ciencia, pero la mayoría de las cifras salen de su propio anuncio.
TL;DR: puntos clave
- Precio: Gemini 4 Neon cuesta 3 $ por millón de tokens de entrada y 15 $ por millón de salida, con entrada en caché a 0,15 $, según el anuncio de Google.
- Coste por tarea: con su nivel de razonamiento
highpor defecto, Neon cuesta un 32 % menos por tarea que Gemini 4 Carbon, según Google. - Inteligencia: Artificial Analysis puntúa a Neon con 61 en su Intelligence Index con el nivel de razonamiento más alto, tercero en el global, según recoge AlphaSignal.
- Código y agentes: Neon logra 58,6 en el Artificial Analysis Coding Agent Index y un 56,3 % en AutomationBench de Zapier, ambos como primer puesto en el anuncio de Google.
- Seguridad: Google reporta un 0,0 % de éxito de ataques en el benchmark de inyección de prompts indirecta de Gray Swan con el nivel de razonamiento más alto y las salvaguardas en tiempo real activas (Google).
- Matiz: las pruebas independientes todavía son pocas, y Claude Opus 5.5 puntúa algo más alto en Terminal-Bench 4.1 y FrontierCode 2.0, según AlphaSignal.
Resumen rápido
| Dato | Gemini 4 Neon |
|---|---|
| Proveedor | |
| Fecha de lanzamiento | 18 de noviembre de 2026 |
| Posición en la familia | Entre Gemini 4 Carbon (el trabajo más difícil y largo) y Gemini 4 Hydrogen (el día a día rápido) |
| Ventana de contexto | 1 millón de tokens |
| Precio de la API | 3 $ de entrada y 15 $ de salida por millón de tokens |
| Entrada en caché | 0,15 $ por millón de tokens |
| Niveles de razonamiento | Google nombra high (por defecto) y xhigh; algunos medios hablan de cuatro niveles |
| API gratuita | No, solo plan de pago |
| Pesos abiertos | No |
| Dónde usarlo | Gemini API en Google AI Studio, app de Gemini (AI Pro y Ultra), Google Antigravity y Gemini for business |
Fuentes: Google y AI Release Tracker.
Dónde encaja el modelo en la familia Gemini 4
Gemini 4 Neon es el modelo equilibrado de Gemini 4 para código complejo, razonamiento analítico y flujos de trabajo empresariales. Google lo sitúa entre Carbon, pensado para los proyectos más difíciles y largos, y Hydrogen, pensado para la ejecución rápida del día a día. Llegó el 18 de noviembre de 2026, seis días después de Gemini 4 Hydrogen.
The Decoder (2026) lo cuenta como el cuarto modelo nuevo de Gemini en un mes. En la app de Gemini sustituye a Argon en el selector de modelos, bajo "Deeper analysis", según Digital Trends (2026) y 9to5Google (2026).
El diseño de la familia importa para los agentes. Según el equipo de Google Antigravity (2026), Neon puede planificar y definir la arquitectura. Los subagentes Hydrogen se encargan de ediciones de código rutinarias, actualizaciones de paquetes y ejecución de tests. Cuando Hydrogen se atasca, devuelve el trabajo a Neon, que repara el plan y retoma la ejecución.
Benchmarks de Gemini 4 Neon
Google reporta que Gemini 4 Neon logra 61 en el Artificial Analysis Intelligence Index, tercero en el global, y el primer puesto en el Artificial Analysis Coding Agent Index con 58,6. También reporta un 70,9 % en Vals Index y un 56,3 % en AutomationBench. El resto de las puntuaciones de la tabla salen de pruebas del propio Google.
| Benchmark | Gemini 4 Neon | Cifra publicada por |
|---|---|---|
Artificial Analysis Intelligence Index (xhigh) | 61, tercero en el global | Artificial Analysis |
| Artificial Analysis Coding Agent Index | 58,6, primero | Artificial Analysis |
| Vals Index | 70,9 % | Vals |
| AutomationBench (Zapier) | 56,3 % | Zapier |
| Vending-Bench 2 (saldo final) | 16 843 $, primero | Andon Labs |
| Terminal-Bench 4.1 | 65,2 % | Reportado por Google |
FrontierCode 2.0 (high) | 46,2 % | Reportado por Google |
| Terminal-Bench Science | 70,5 % | Reportado por Google |
| RiemannBench | 84,0 % | Reportado por Google |
| HLE-Diamond | 71,3 % | Reportado por Google |
| SWE-sweep, entorno mini-SWE | 12,8 % | Reportado por Google |
| SWE-sweep, Google Antigravity | 39,0 % | Reportado por Google |
Fuentes: Google, AlphaSignal (2026) y AI Release Tracker. Las puntuaciones son con el nivel xhigh, salvo que se indique otra cosa.
Cómo lo hemos comparado
No hemos ejecutado estos benchmarks. Hemos reunido las cifras del anuncio de Google y de la prensa, y hemos etiquetado cada una según quién la publica. Las puntuaciones salen de entornos de prueba distintos, así que un número solo es comparable dentro de su propia fila.
Hay dos detalles que cambian cómo leer la tabla. El primero: el mismo modelo saca un 12,8 % en SWE-sweep en un entorno y un 39,0 % en otro, así que el entorno de prueba mueve mucho el resultado. El segundo: los rankings dependen de qué modelos cuenta cada fuente. Google sitúa a Neon primero en AutomationBench, mientras que AI Release Tracker lo coloca tercero de 33 modelos, por detrás de DeepSeek-V4.1-Flash-1017 con un 60,5 %.
Gemini 4 Neon frente a la familia Gemini 4
En Artificial Analysis, Gemini 4 Neon logra 61 en el Intelligence Index con xhigh y 60 con high. Es un punto más que Gemini 4 Carbon con high y bastante más que Hydrogen (54) y Argon (50). Con high, Neon usó 123 millones de tokens de salida en la ejecución completa del índice, frente a 205 millones de Carbon.
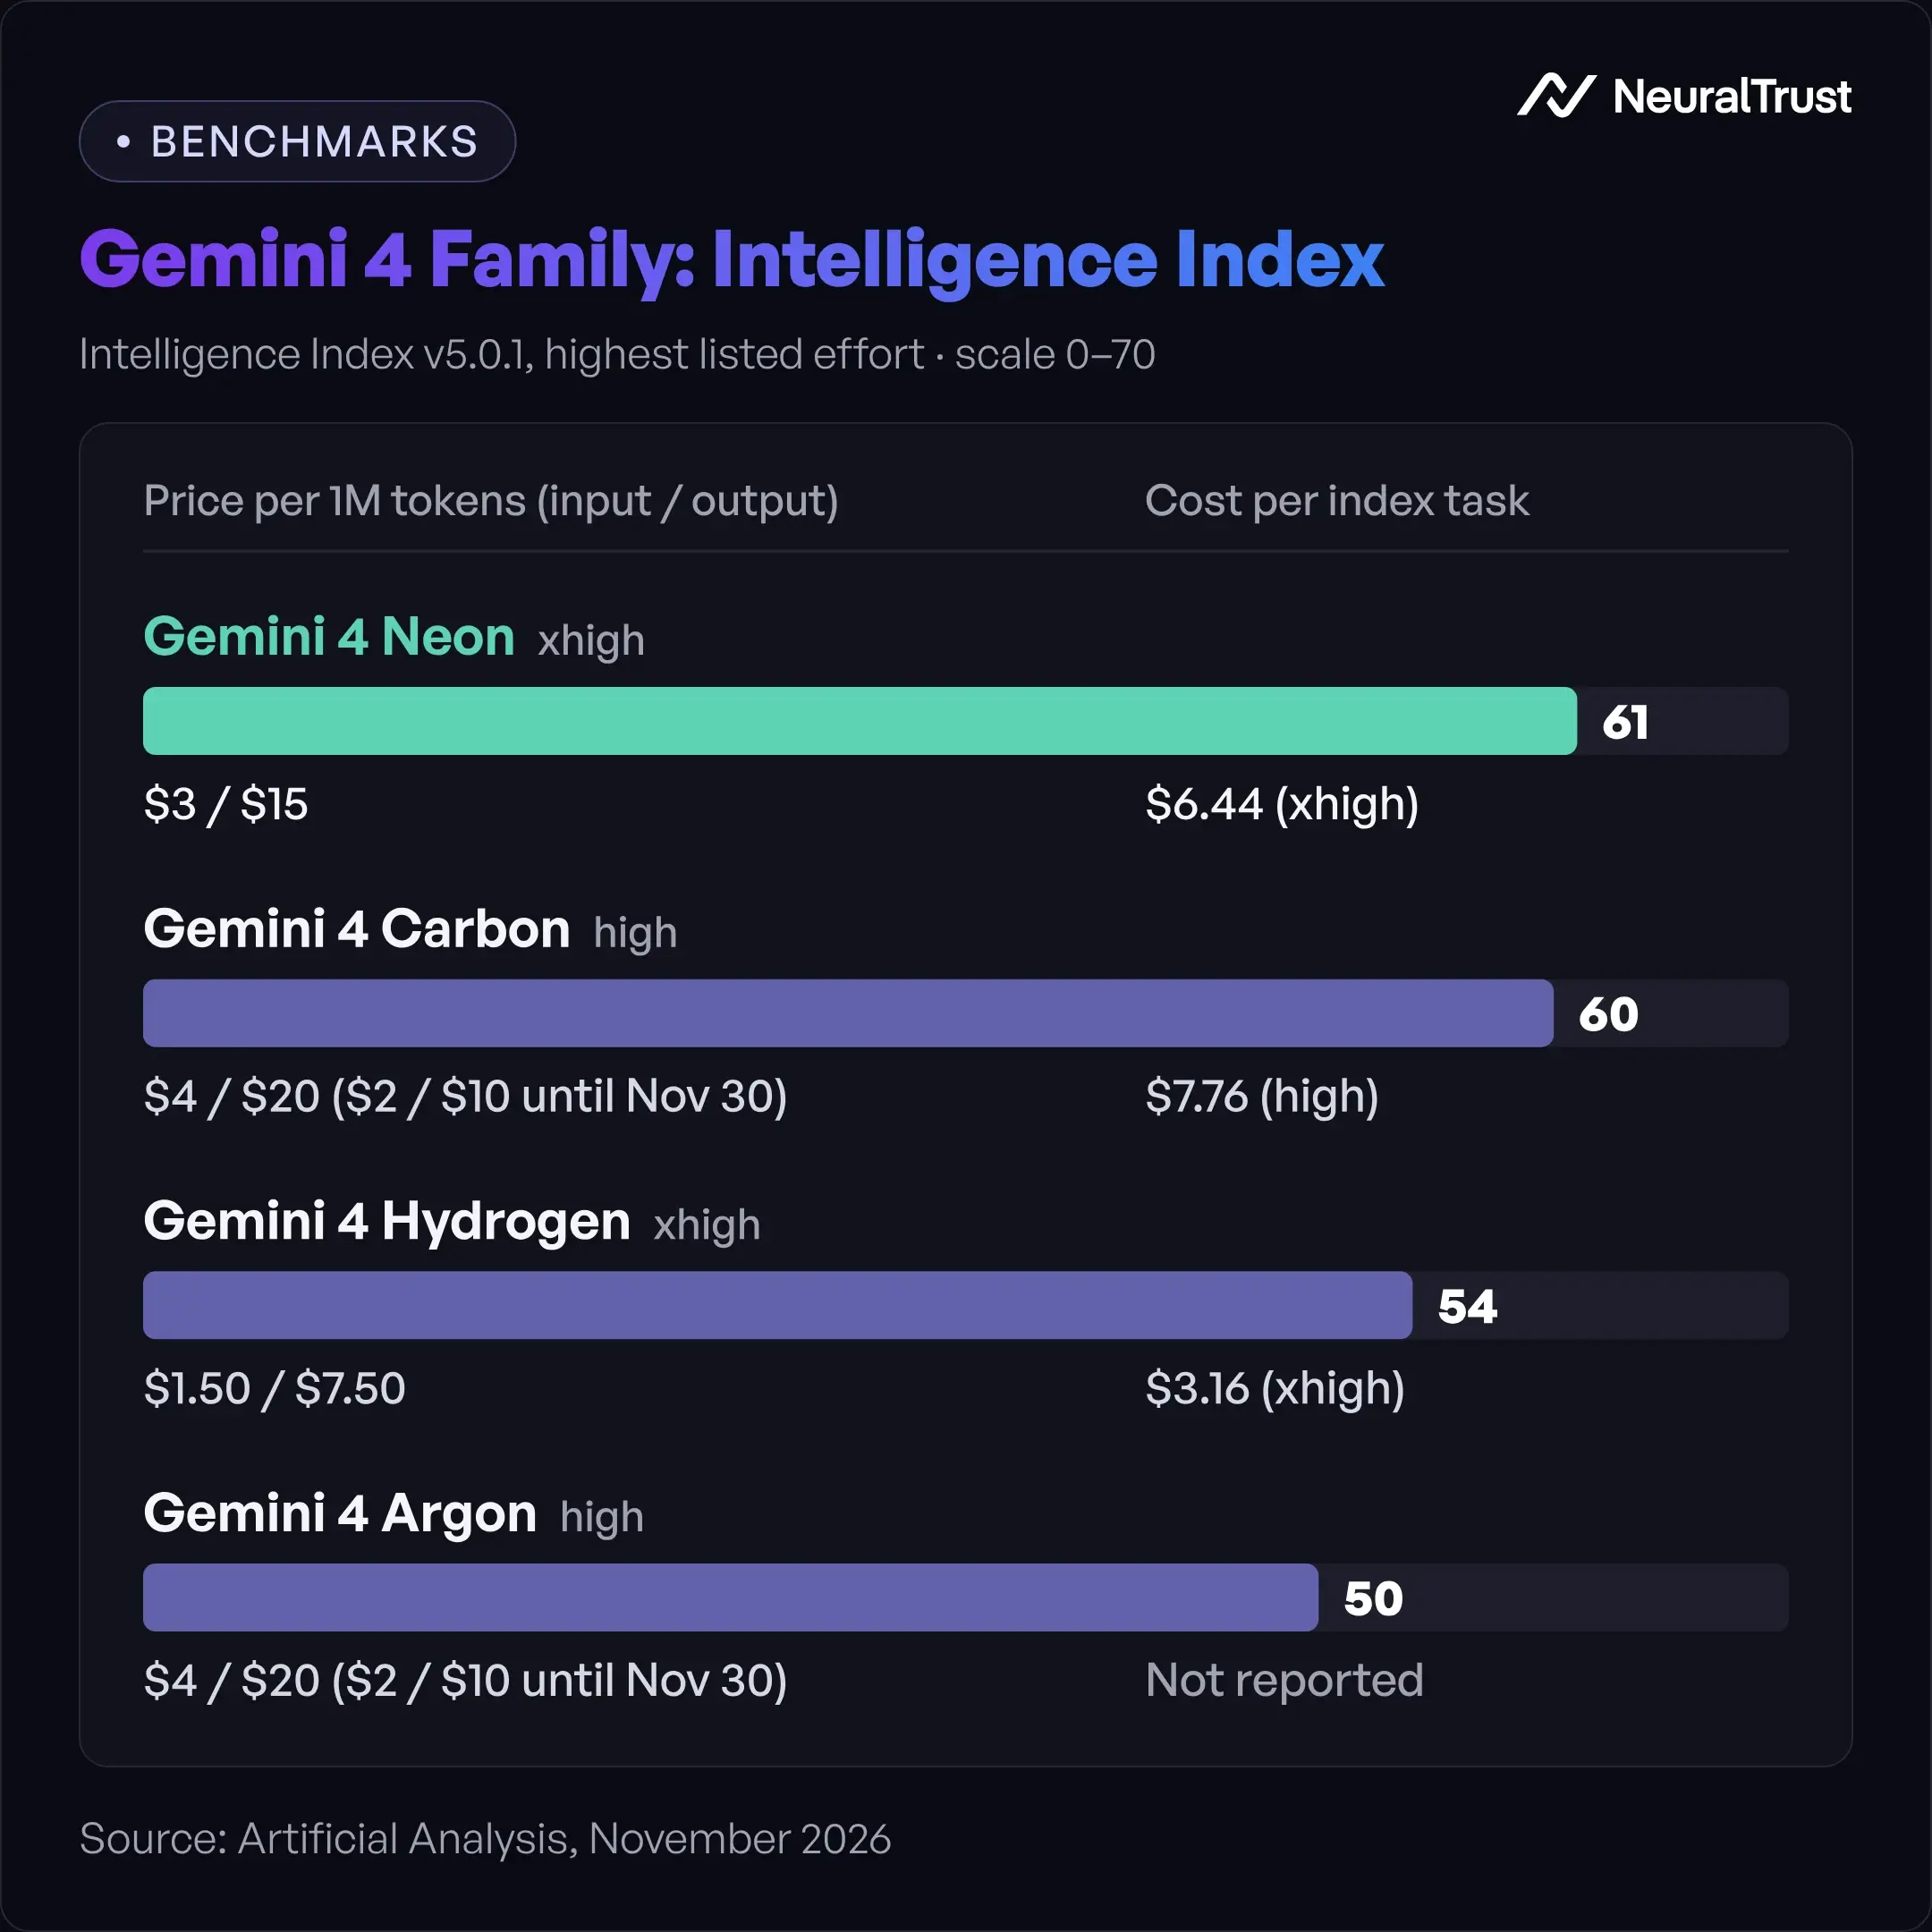
| Modelo | Intelligence Index | Tokens de salida, ejecución completa del índice | Precio por 1M de tokens (entrada / salida) | Coste por tarea del índice |
|---|---|---|---|---|
| Gemini 4 Neon | 61 (xhigh), 60 (high, por defecto) | 283 M (xhigh), 123 M (high) | 3 $ / 15 $ | 6,44 $ (xhigh) |
| Gemini 4 Carbon | 60 (high), 58 (medium, por defecto) | 205 M (high) | 4 $ / 20 $, o 2 $ / 10 $ hasta el 30 nov | 7,76 $ (high, precio estándar) |
| Gemini 4 Hydrogen | 54 (xhigh), 51 (high, por defecto) | 304 M (xhigh), 110 M (high) | 1,50 $ / 7,50 $ | 3,16 $ (xhigh) |
| Gemini 4 Argon | 50 (high), 48 (medium, por defecto) | 113 M (high) | 4 $ / 20 $, o 2 $ / 10 $ hasta el 30 nov | No reportado |
Fuentes: Artificial Analysis (2026) y sus páginas de modelo de Neon, Carbon, Argon y Hydrogen, versión 5.0.1 del índice. Los precios salen de 9to5Google (2026). Carbon sacó 59 en el artículo de lanzamiento de octubre de Artificial Analysis y 60 en su página de modelo actual, y la tabla usa la página de modelo.
Las tablas de lanzamiento de Google añaden puntuaciones por tarea. Neon supera a Carbon en cuatro de las seis filas siguientes y se queda por detrás en Agents' Last Exam y en GraphWalks. Supera a Hydrogen en todas las filas donde aparecen los dos.
| Benchmark | Neon | Carbon | Hydrogen | Argon | Cifra de |
|---|---|---|---|---|---|
| Agents' Last Exam v1.1 | 75,8 % | 77,4 % | 71,6 % | 69,0 % | |
| AutomationBench | 56,3 % | 53,9 % | No reportado | 51,3 % | Zapier |
| Vals Index | 70,9 % | 70,4 % | No reportado | 69,2 % | Vals |
| Vending-Bench 2 (saldo final) | 16 843 $ | 16 484 $ | 14 549 $ | 13 718 $ | Andon Labs |
| Terminal-Bench Science | 70,5 % | 64,8 % | 51,4 % | 52,9 % | |
| GraphWalks BFS, 256K a 1M de tokens | 95,2 % | 96,2 % | No reportado | 84,2 % |
Fuentes: Google, AI Release Tracker y SmartScope (2026). Las cifras salen de tablas de lanzamiento distintas, con modelos de comparación diferentes. SmartScope avisa de que no conviene alinear números de tablas distintas, así que trata las diferencias de uno o dos puntos como empates.
Google también dice que Neon reduce el servicio insuficiente entre un 43 % y un 56 % y la extralimitación entre un 15 % y un 35 % frente a Carbon, según el nivel de razonamiento. Para agentes con acceso a herramientas, la extralimitación es la cifra que más importa. En resumen, Neon es el modelo Gemini 4 con mejor puntuación en esta comparación y su precio de lista queda por debajo del estándar de Carbon. Carbon mantiene ventaja en razonamiento sobre grafos de contexto largo, y Hydrogen es el más barato.
Gemini 4 Neon frente a los mejores modelos del mercado
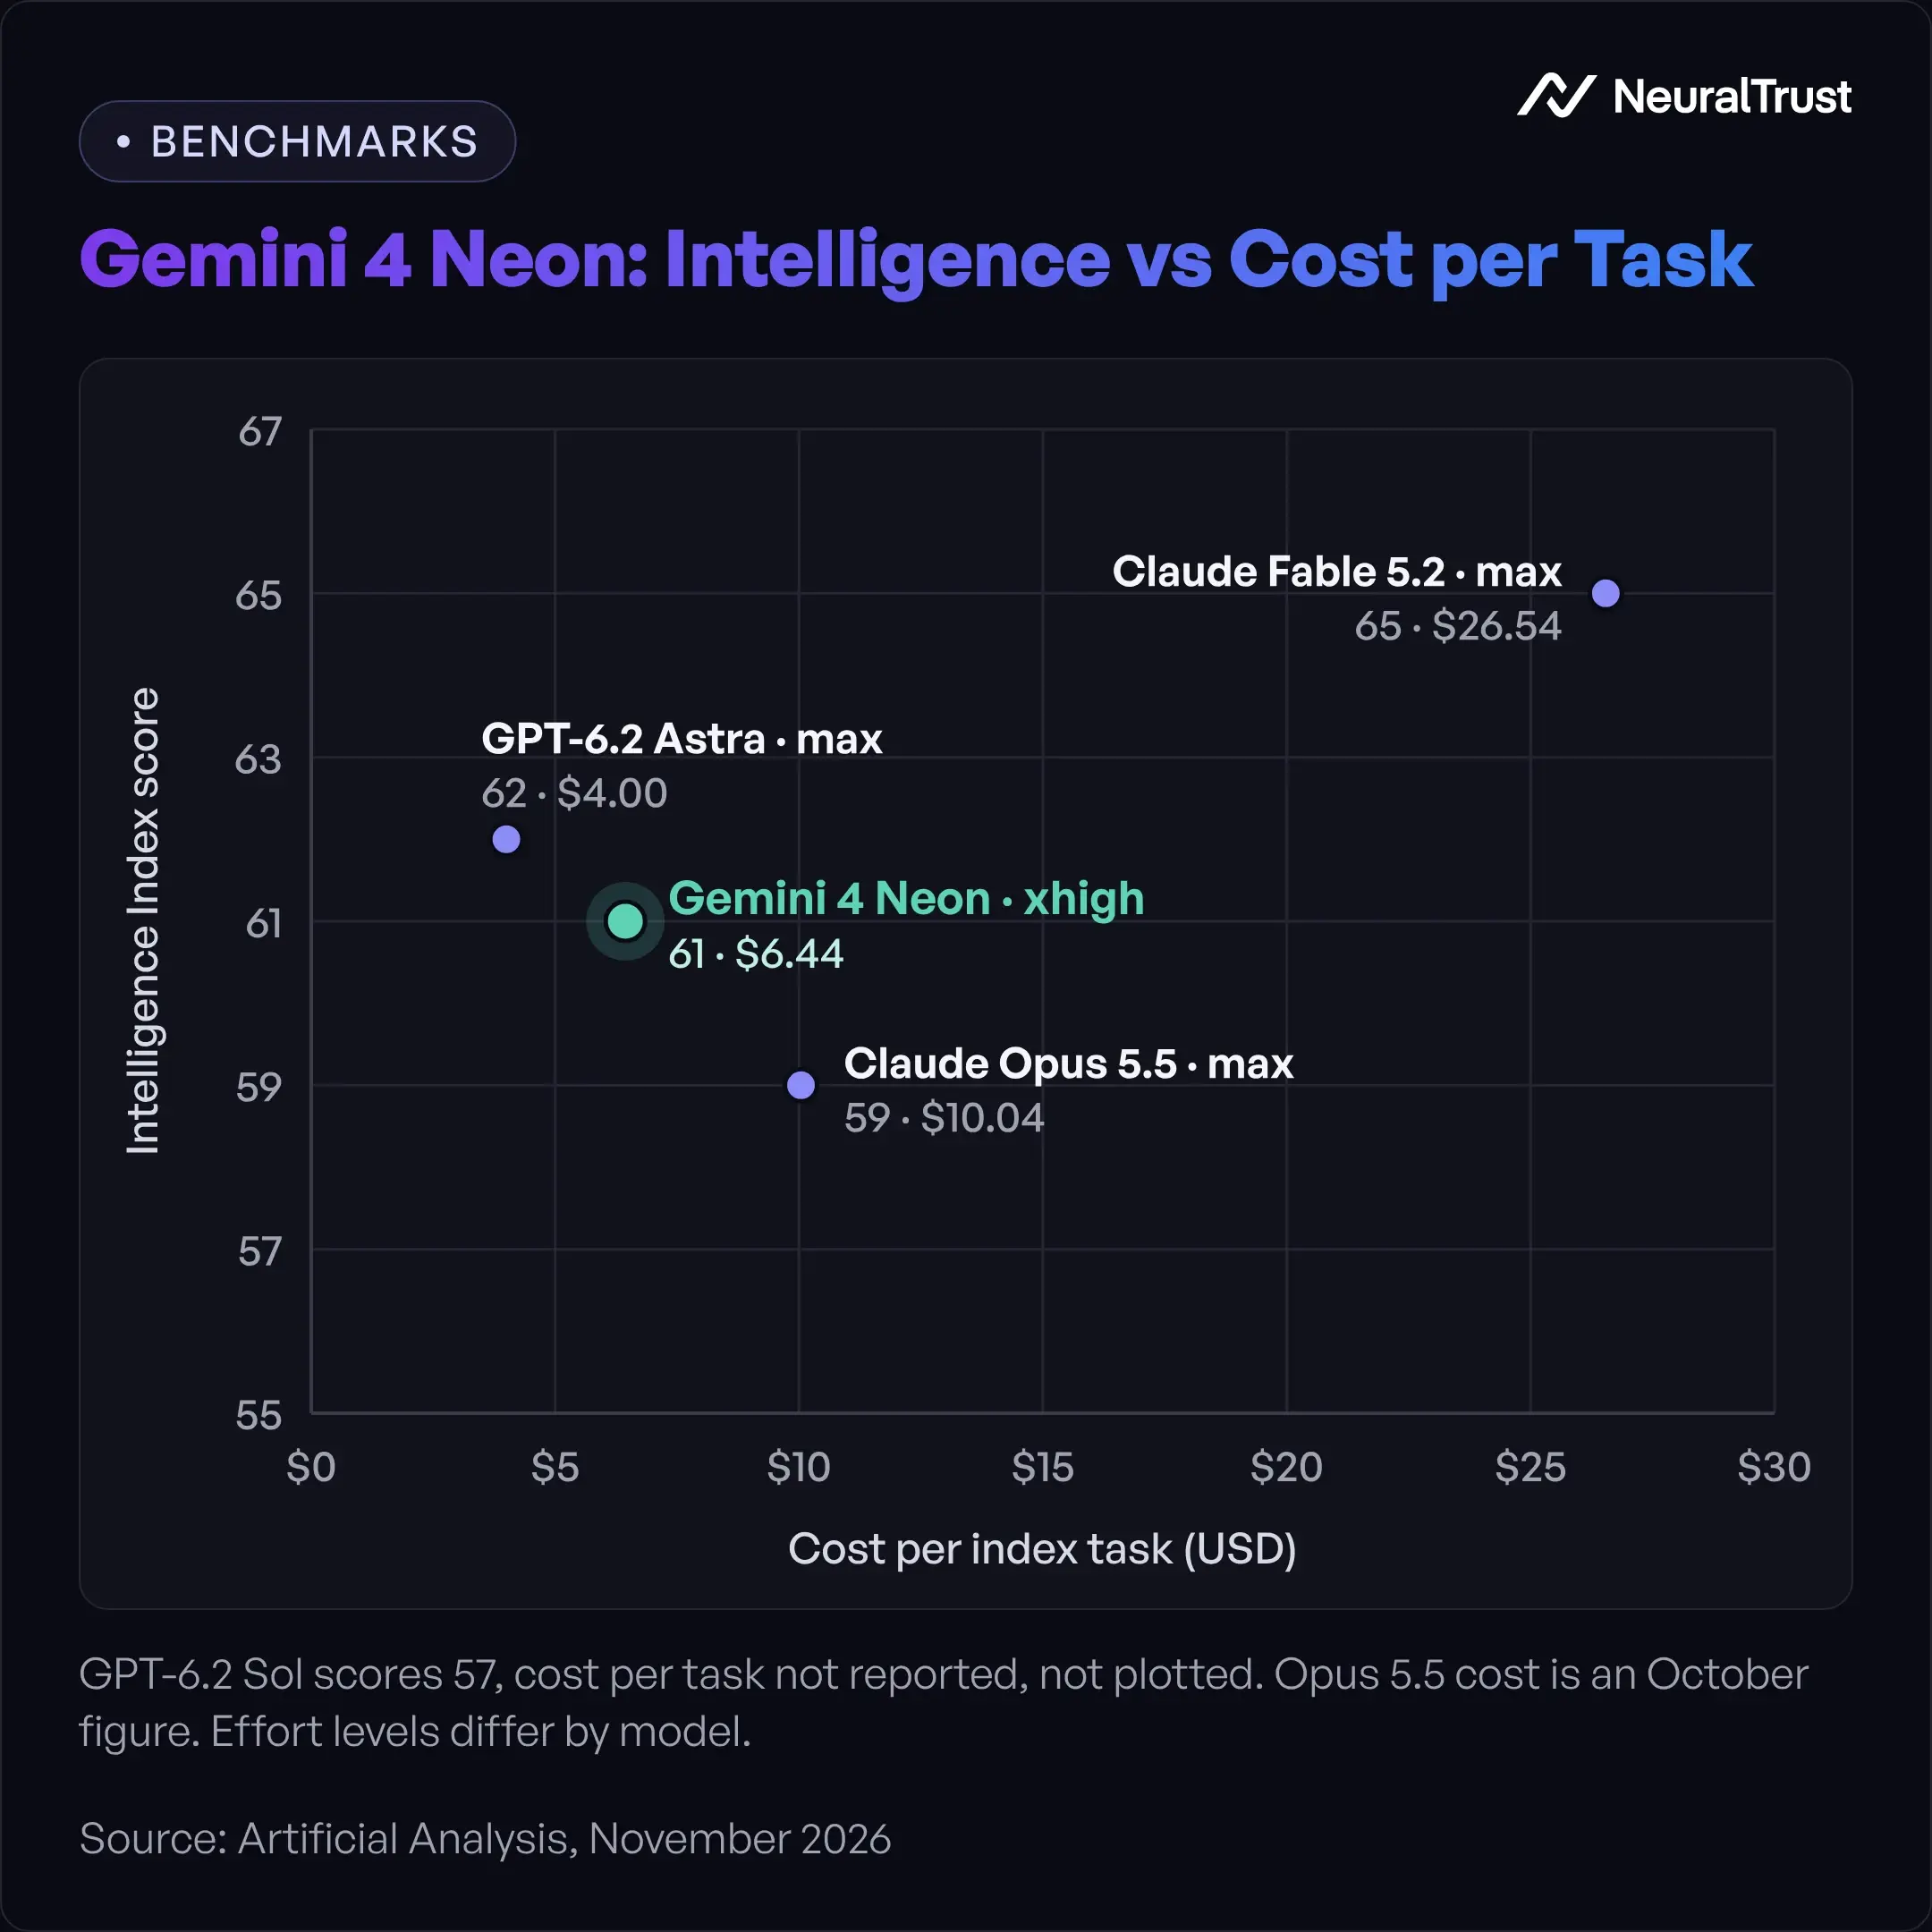
Claude Fable 5.2 lidera el Artificial Analysis Intelligence Index con 65, seguido de GPT-6.2 Astra con 62 y Gemini 4 Neon con 61. Neon lidera el Coding Agent Index con 59 y su precio por token es menor que el de Fable 5.2 y Astra, pero el uso de tokens cambia el coste por tarea.
| Modelo | Intelligence Index | Coding Agent Index | Precio por 1M de tokens (entrada / salida) | Coste por tarea del índice | Tokens de salida, ejecución completa del índice |
|---|---|---|---|---|---|
| Claude Fable 5.2 | 65 (max) | 58 (xhigh, Claude Code) | 8 $ / 40 $ | 26,54 $ (max) | 275 M (max) |
| GPT-6.2 Astra | 62 (max) | No reportado | 8 $ / 40 $ | 4,00 $ (max) | 65,8 M (max) |
| Gemini 4 Neon | 61 (xhigh) | 59 (xhigh, Antigravity CLI) | 3 $ / 15 $ | 6,44 $ (xhigh) | 283 M (xhigh) |
| Claude Opus 5.5 | 59 (max) | 58 (max, Claude Code) | No verificado | 10,04 $ (max, cifra de octubre) | No reportado |
| GPT-6.2 Sol | 57 | No reportado | 2 $ / 10 $ | No reportado | No reportado |
Fuentes: páginas de Artificial Analysis de Claude Fable 5.2 y GPT-6.2 Astra, y sus artículos sobre Gemini 4 Neon, GPT-6.2 Astra y Sol y Gemini 4 Carbon, este último para el coste de Opus 5.5. La tabla no compara en igualdad de condiciones. Cada puntuación usa el nivel de esfuerzo más alto que figura para ese modelo, así que Neon va con xhigh mientras que Fable 5.2 y Astra van con max. El coste por tarea del índice es el coste ponderado de Artificial Analysis para una tarea del Intelligence Index. Las pruebas del Coding Agent Index usan las herramientas de agente de cada proveedor.
Los números dicen tres cosas. Fable 5.2 es el más capaz y el más caro, con 26,54 $ por tarea del índice, aproximadamente cuatro veces los 6,44 $ de Neon. Astra puntúa un punto más que Neon y cuesta menos ejecutarlo, con 4,00 $ por tarea. Su precio de lista es de 8 $ y 40 $, pero usó 65,8 millones de tokens de salida frente a los 283 millones de Neon con xhigh. Y la ventaja de un punto de Neon en el Coding Agent Index es lo bastante pequeña como para que la compruebes en tus propios repositorios.
Con su ajuste por defecto high, Neon puntúa 60 y usó 123 millones de tokens de salida, pero Artificial Analysis no publica un coste por tarea para ese ajuste. El puesto también depende de cómo se cuente. El artículo de lanzamiento de Artificial Analysis coloca a Neon tercero, por detrás de Astra y Fable 5.2, y su página de modelo lo sitúa en el puesto 6 de 96.
A nivel de tarea, AI Release Tracker sitúa a Neon primero en Vending-Bench 2 y RiemannBench y por detrás del líder en otros tres benchmarks.
| Benchmark | Gemini 4 Neon | Puesto en AI Release Tracker | Mejor puntuación en el tracker |
|---|---|---|---|
| Vending-Bench 2 (saldo final) | 16 843 $ | 1.º | Gemini 4 Neon |
| RiemannBench | 84,0 % | 1.º | Gemini 4 Neon |
| FrontierCode 2.0 | 46,2 % | 2.º de 9 | Claude Fable 5.2, 49,1 % |
| AutomationBench | 56,3 % | 3.º de 33 | DeepSeek-V4.1-Flash-1017, 60,5 % |
| Terminal-Bench Science | 70,5 % | 4.º de 19 | GPT-6.2 Astra, 77,1 % |
Fuente: AI Release Tracker. Los puestos solo cuentan los modelos que lista el tracker, y Google reporta a Neon primero en AutomationBench.
[IMAGE 2: puntuación del Intelligence Index frente al coste por tarea de los modelos líderes]
Dónde se queda atrás Gemini 4 Neon
Neon no lidera en todo. AlphaSignal (2026) reporta que Claude Opus 5.5 puntúa algo más alto en Terminal-Bench 4.1 y FrontierCode 2.0, y Digital Trends reporta a GPT-6.2 Sol por delante en Chartography. En el Artificial Analysis Intelligence Index, el 61 de Neon queda por detrás de Claude Fable 5.2 con 65 y GPT-6.2 Astra con 62.
La misma cobertura señala que las pruebas independientes siguen siendo escasas. Trata la tabla de lanzamiento como el mejor caso de Google y repítela con tus propias tareas.
Precio y coste por tarea
Gemini 4 Neon cuesta 3 $ por millón de tokens de entrada y 15 $ por millón de salida. La entrada en caché cuesta 0,15 $ por millón, un 95 % de descuento. No hay API gratuita, y AI Release Tracker reporta un precio plano en toda la ventana de 1 048 576 tokens, sin recargo por contexto largo.
| Modelo | Entrada por 1M | Salida por 1M | Nota |
|---|---|---|---|
| Gemini 4 Neon | 3,00 $ | 15,00 $ | Entrada en caché a 0,15 $ |
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | La mitad del precio de Neon |
| Gemini 4 Carbon y Argon | 2,00 $, luego 4,00 $ | 10,00 $, luego 20,00 $ | La tarifa introductoria termina después del 30 de noviembre de 2026 |
Fuentes: 9to5Google (2026) y AlphaSignal (2026). Cuando suba la tarifa de Carbon, Neon será un 25 % más barato por token que Carbon. Hasta entonces cuesta un 50 % más.
[IMAGE 3: escalera de precios de la familia Gemini 4]
Así queda por petición con precios de lista. Una petición con 20 000 tokens de entrada y 4000 de salida cuesta 0,12 $: 0,06 $ de entrada y 0,06 $ de salida. Si 15 000 de los tokens de entrada vienen de la caché, la entrada baja a unos 0,017 $ y el total a unos 0,077 $. Los tokens de razonamiento se facturan como salida, así que las peticiones con mucho razonamiento cuestan más que este ejemplo.
Coste por tarea
El precio por token es solo la mitad de la factura. Google asegura que Neon con high cuesta un 32 % menos por tarea que Carbon. Dice también que cuesta entre un 50 % y un 80 % menos que los principales modelos frontier en Vals Index y Agent Arena. Con xhigh, afirma un coste al menos un 36 % menor que el de sus rivales con sus ajustes más altos.
Son cifras de Google, y los ahorros principales se miden con high mientras que las mejores puntuaciones salen de xhigh. El uso de tokens importa tanto como el precio de lista. AlphaSignal (2026) recoge que Artificial Analysis registró unos 200 millones de tokens de salida para Carbon en una ejecución completa del índice. La mediana entre los modelos probados fue de 64 millones.
Dónde usarlo y qué cambiar
Neon está disponible en la Gemini API de pago en Google AI Studio, en la app de Gemini para suscriptores de AI Pro y Ultra, en Google Antigravity y a través de Gemini for business. Según AlphaSignal (2026), migrar desde Carbon o Argon exige algunos cambios:
- Usa el ID de modelo
gemini-4-neon, que por defecto usahighy también admitexhigh. - Elimina
temperature,top_pytop_k, porque los valores fuera de rango devuelven un HTTP 400. - Pon timeouts de cliente de al menos 15 minutos, o usa ejecución en segundo plano.
- Usa function calling nativo, porque las llamadas a herramientas en JSON sin procesar pueden devolver
MALFORMED_FUNCTION_CALL.
Comprueba estos detalles en la documentación de la API de Google antes de tocar producción, porque no pudimos abrir esa página.
Seguridad y gobernanza de Gemini 4 Neon
Google dice que Gemini 4 Neon mantiene protecciones de nivel Gemini 4 Carbon frente al mal uso grave y la inyección de prompts. Reporta un 0,0 % de éxito de ataques en el benchmark de inyección de prompts indirecta de Gray Swan con el nivel de razonamiento más alto. Son resultados del proveedor en una sola configuración. No sustituyen a los controles alrededor de los agentes que construyas sobre Neon.
| Medida de seguridad | Resultado reportado por Google |
|---|---|
| Inyección de prompts indirecta de Gray Swan, éxito del ataque | 0,0 % con el nivel de razonamiento más alto y salvaguardas activas |
| Suite de seguridad agéntica, tasa de acciones desalineadas | 0,09 % |
| Evaluación de honestidad del agente, tasa de aprobados | 99,2 % |
| Tareas de código en las que el modelo tomó atajos | 2,45 %, la más baja de cualquier modelo Gemini 4 |
| Trampas en Terminal-Bench 4.0 | 0,0 %, igual que Carbon |
| Tareas rechazadas (exceso de rechazo) | 1,98 % en Terminal-Bench 4.0, 0 % en Terminal-Bench Science |
Fuente: anuncio de Google. No pudimos abrir la model card de Gemini 4 Neon, así que estas cifras salen solo del anuncio y de la cobertura de prensa.
[IMAGE 4: capas de control alrededor de un agente con Gemini 4 Neon]
Neon for cyber y el Fairwind Program
Google también anunció una variante para ciberseguridad, Neon for cyber, para generación de código seguro, búsqueda de vulnerabilidades, validación de exploits y parcheo. El acceso va primero a los miembros elegibles del Fairwind Program, un programa para defensores de confianza, y Google pide a los clientes interesados que contacten con su equipo de cuenta de Cloud.
Los números son sólidos. Google reporta un 90,5 % en SEC-bench Pro, un 76 % en el nivel difícil de AutoBaxBench, un 70,7 % en CWE-bench v2 de Collinear y un 51,26 % en WebExploitBench v1.2. AI Release Tracker añade que el resultado de SEC-bench Pro se evaluó con los filtros de seguridad desactivados. Las mismas capacidades que ayudan a los defensores también ayudan a los atacantes, y por eso Google limita esta variante a miembros verificados.
Lo que los benchmarks no cubren
Según Help Net Security (2026), el OWASP Top 10 para aplicaciones LLM de 2026 mantiene Prompt Injection en el primer puesto y Sensitive Information Disclosure en el segundo. Excessive Agency sube al tercer puesto. La lista se elaboró con un 75 % de votos de expertos y un 25 % de datos de incidentes, con 6639 incidentes reales.
Esa clasificación encaja con cómo se pretende usar Neon. Un orquestador que dirige subagentes en paralelo tiene más herramientas, más acceso a datos y más margen de acción que un modelo de chat. Un 0,0 % en un benchmark de inyección de prompts dice poco sobre tus herramientas, tus servidores MCP o tus datos. Las salvaguardas del modelo son una capa, y las empresas necesitan controles fuera del modelo.
NeuralTrust es una empresa de seguridad para agentes de IA con sede en Barcelona, y la tabla asocia cada riesgo con un control.
| Riesgo con un agente basado en Neon | Control | Capacidad de NeuralTrust |
|---|---|---|
| Modelos, herramientas y servidores MCP sin aprobar en uso | Saber qué agentes se ejecutan y a qué pueden acceder | Agent Posture Management (TrustLens) |
| Inyección de prompts y fuga de datos en el tráfico real | Aplicar políticas a cada petición y respuesta | Agent Gateway (TrustGate) |
| Mal uso o desvío mientras el agente se ejecuta | Monitorizar el comportamiento del agente en runtime | Agent Runtime Security (TrustGuard) |
| Huecos que los benchmarks del proveedor no prueban | Probar el agente con tus propios casos de ataque antes del lanzamiento | AI Red Teaming (TrustTest) |
Estas capacidades forman el Runtime Security Mesh de NeuralTrust.
¿Qué deberías elegir?
Elige por carga de trabajo y por riesgo, no por el ranking del día del lanzamiento. Neon encaja con equipos que quieren resultados cercanos a Carbon con menor coste por tarea, Hydrogen encaja con trabajo simple de alto volumen y Carbon encaja con los proyectos más difíciles. Primero hay que confirmar las cifras de Google con tus propias tareas.
| Si eres... | Considera | Por qué |
|---|---|---|
| Un equipo de plataforma que ejecuta flujos de agentes a escala | Gemini 4 Neon con high | Google reporta un 32 % menos de coste por tarea que Carbon |
| Alguien que trabaja en los proyectos de ingeniería más difíciles y largos | Prueba primero Neon, después Gemini 4 Carbon | Google sitúa a Carbon para estos proyectos y reporta resultados comparables de Neon con menor coste |
| Alguien con tareas simples de alto volumen o subagentes | Gemini 4 Hydrogen | Cuesta 1,50 $ de entrada y 7,50 $ de salida, la mitad que Neon |
| Alguien con trabajo de terminal y código donde los rivales lideran | Compara Neon con Claude Opus 5.5 | Opus 5.5 puntúa algo más alto en Terminal-Bench 4.1 y FrontierCode 2.0 |
| Un equipo en un entorno regulado o sensible a la seguridad | Cualquier modelo, con controles fuera de él | Un gateway, la monitorización en runtime y las revisiones de postura valen para el modelo que elijas |
Conclusión
Gemini 4 Neon ofrece a Google un modelo Gemini 4 de precio intermedio, con una ventana de contexto de 1 millón de tokens y buenas puntuaciones en agentes y código. Su precio de 3 $ y 15 $ por millón de tokens queda por encima de Hydrogen y, después del 30 de noviembre, por debajo de Carbon, y merece la pena probar el 32 % de ahorro por tarea que anuncia Google. Casi toda la evidencia viene del proveedor, así que haz tu propia evaluación. Elijas el modelo que elijas, trata sus resultados de seguridad como una capa más y añade controles alrededor del agente.
Protege tus agentes con Gemini 4 Neon en producción con NeuralTrust
Pon políticas, monitorización y pruebas alrededor de cada agente que construyas sobre un modelo nuevo, desde el primer día.
Comparativas relacionadas
- Gemini 4 Neon vs Claude Opus 5.5: enrutamiento y fallback en AI gateway
- Gemini 4 Hydrogen: benchmarks, precios y seguridad
- Seguridad de Claude Opus 5.5 en la empresa: qué cubren las salvaguardas integradas
- GPT-6 Astra: lo que todo CISO debe saber
Preguntas frecuentes sobre Gemini 4 Neon
1. ¿Qué es Gemini 4 Neon?
Gemini 4 Neon es un modelo de Google lanzado el 18 de noviembre de 2026. Se sitúa entre Gemini 4 Carbon y Gemini 4 Hydrogen y apunta a código complejo, razonamiento analítico y flujos de trabajo empresariales. Tiene una ventana de contexto de 1 millón de tokens. Puedes usarlo en la Gemini API de pago, en la app de Gemini con AI Pro y Ultra, en Google Antigravity y en Gemini for business.
2. ¿Cuánto cuesta Gemini 4 Neon?
Gemini 4 Neon cuesta 3 $ por millón de tokens de entrada y 15 $ por millón de tokens de salida. La entrada en caché cuesta 0,15 $ por millón de tokens. No hay API gratuita, y los tokens de razonamiento se facturan como salida. Es el doble que Gemini 4 Hydrogen y un 25 % menos que Carbon cuando acabe su tarifa introductoria, después del 30 de noviembre de 2026.
3. ¿Es Gemini 4 Neon mejor que Claude Opus 5.5 y GPT-6.2 Sol?
Depende de la tarea. Google reporta a Neon con 61 en el Artificial Analysis Intelligence Index, por delante de Opus 5.5 con 59 y GPT-6.2 Sol con 57, según Digital Trends. Opus 5.5 puntúa algo más alto en Terminal-Bench 4.1 y FrontierCode 2.0. La mayoría de las cifras son del proveedor, así que pruébalo con tu propia carga de trabajo.
4. ¿Qué ventana de contexto tiene Gemini 4 Neon?
Gemini 4 Neon tiene una ventana de contexto de 1 millón de tokens, que AI Release Tracker concreta en 1 048 576 tokens. El precio es plano en toda la ventana, sin recargo por contexto largo. The Decoder también habla de un límite de salida de hasta un millón de tokens, una cifra que no pudimos confirmar en la documentación de Google.
5. ¿Es seguro Gemini 4 Neon frente a la inyección de prompts?
Google reporta un 0,0 % de éxito de ataques en el benchmark de inyección de prompts indirecta de Gray Swan con el nivel de razonamiento más alto y las salvaguardas en tiempo real activas. Es un benchmark en una configuración. Tus herramientas, servidores MCP y datos generan riesgos que ese benchmark no prueba, así que añade un gateway y monitorización en runtime alrededor del agente.
6. ¿Qué es el Fairwind Program?
El Fairwind Program es el programa de Google para defensores de confianza. Los miembros elegibles reciben acceso a Neon for cyber, una variante para generación de código seguro, búsqueda de vulnerabilidades, validación de exploits y parcheo. Google dice que los miembros tendrán acceso en los días siguientes y pide a los clientes interesados que contacten con su equipo de cuenta de Cloud.
7. ¿Puedo usar Gemini 4 Neon gratis?
No. Gemini 4 Neon no tiene API gratuita, así que la Gemini API exige el plan de pago. Los suscriptores de Google AI Pro y Ultra pueden usarlo en la app de Gemini, en Google AI Studio y en Google Antigravity. Google no ha dicho si los usuarios gratuitos de la app de Gemini recibirán Neon.
Sobre el autor
Roger Howroyd es Head of Global SEO and AI en NeuralTrust, donde lidera la estrategia de búsqueda de la compañía en SEO, AEO, GEO y optimización para LLM. Se especializa en búsqueda con IA, estrategia de contenidos y SEM. Conecta en LinkedIn.
NeuralTrust es la plataforma líder para proteger y escalar agentes de IA. Reconocida como Pioneer en el Gartner Emerging Market Quadrant for AI Application Security 2026, citada en cuatro Gartner Hype Cycle reports de 2026 y presente en el Gartner Market Guide for Guardian Agents 2026, el Gartner Market Guide for AI Gateways 2025 y el KuppingerCole Leadership Compass for Generative AI Defense 2025. Con sede en Barcelona y oficinas en Londres y Nueva York. Certificada ISO 27001.
Fuentes
- Google, "Introducing Gemini 4 Neon", 18 de noviembre de 2026: https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/
- Google Antigravity, "Gemini 4 Neon in Google Antigravity", 18 de noviembre de 2026: https://antigravity.google/blog/gemini-4-neon-in-google-antigravity/
- AI Release Tracker, "Gemini 4 Neon", consultado el 19 de noviembre de 2026: https://aireleasetracker.com/model/google/gemini-4-neon
- 9to5Google, "Google launches Gemini 4 Neon", 18 de noviembre de 2026: https://9to5google.com/2026/11/18/gemini-4-neon-announcement/
- Digital Trends, "Google says Gemini 4 Neon can hang with Claude Opus 5.5 and GPT-6.2 Sol for less", 18 de noviembre de 2026: https://www.digitaltrends.com/computing/google-says-gemini-4-neon-can-hang-with-claude-opus-5-5-and-gpt-6-2-sol-for-less/
- The Decoder, "Google ships Gemini 4 Neon, its fourth new Gemini model in a month", 18 de noviembre de 2026: https://the-decoder.com/google-ships-gemini-4-neon-its-fourth-new-gemini-model-in-a-month/
- AlphaSignal, "Google DeepMind's Gemini 4 Neon targets complex agent workflows at 61 intelligence score", noviembre de 2026: https://alphasignal.ai/news/google-deepmind-s-gemini-4-neon-targets-complex-agent-workflows-at-61
- Artificial Analysis, "Gemini 4 Neon intelligence gain", 18 de noviembre de 2026, y sus páginas de modelo de Gemini 4 Neon, Carbon, Argon, Hydrogen, Claude Fable 5.2 y GPT-6.2 Astra: https://artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain
- Help Net Security, "OWASP 2026 LLM Top 10", 6 de agosto de 2026: https://www.helpnetsecurity.com/2026/08/06/owasp-2026-llm-top-10-released/
- SmartScope, comparativa de Gemini 4 Hydrogen, Argon y Carbon, 13 de noviembre de 2026: https://smartscope.blog/en/blog/gemini-4-hydrogen-vs-argon-vs-carbon-differences-2026/