¿Qué es la observabilidad de LLMs? La observabilidad de LLM es la práctica de monitorizar en tiempo real cada solicitud, respuesta, token y coste que fluye por tus aplicaciones de IA. Un AI gateway la proporciona automáticamente a nivel de infraestructura, cubriendo todos los modelos y todas las aplicaciones desde un único punto central, sin modificar ningún código de aplicación.
TL;DR - Puntos Clave
- El logging a nivel de SDK ofrece visibilidad parcial por aplicación, un AI gateway ofrece visibilidad completa de todas las aplicaciones, modelos y equipos desde una sola capa
- Las seis métricas que importan en producción de LLM: latencia de solicitudes (p50/p95/p99), uso de tokens, coste por llamada, tasa de errores, tasa de fallback y detección de anomalías
- OpenTelemetry es el estándar emergente para el trazado de LLM, un gateway bien construido emite trazas compatibles con OpenTelemetry automáticamente
- TrustGate recopila datos de observabilidad en la capa del gateway, TrustLens los muestra como inteligencia de postura de agentes en todo tu stack de IA.
Añadiste logging a tu app de LLM. Pero los logs a nivel de aplicación solo muestran lo que hizo una app. Un AI gateway se sitúa upstream de todas tus aplicaciones y todos tus modelos, por lo que lo ve todo: qué equipo está gastando más tokens, qué modelo es lento en p99, qué solicitudes activaron fallbacks. Eso es lo que significa la observabilidad real de LLM. Este artículo explica cómo funciona y qué deberías estar monitorizando.
Crees que Tienes Visibilidad. Probablemente No la Tienes.
Lo veo constantemente. Un equipo lanza una funcionalidad de LLM, añade algo de logging a la app de Python, lo apunta a un dashboard y declara la observabilidad resuelta. Dos meses después, la factura del LLM se duplica de forma inesperada. Aparece un pico de latencia en p99 pero no en p50, así que nadie lo detecta hasta que los clientes enterprise empiezan a quejarse. Un prompt de un equipo filtra datos que pertenecían a otro.
Nada de esto aparece en los logs a nivel de aplicación.
Esta es la brecha de observabilidad en la producción de LLM. No es falta de herramientas. No es falta de intención. Es un problema estructural: estás intentando observar un sistema multi-modelo, multi-equipo y multi-aplicación desde puntos de vista individuales de cada aplicación. Y no funciona.
Un AI gateway resuelve esto. No añadiendo más logging a tus apps. Moviendo la capa de observación al único lugar que lo ve todo.
¿Qué es la Observabilidad de LLM?
La observabilidad de LLM es la práctica de rastrear y entender cada solicitud, respuesta, token y coste que fluye por tus aplicaciones de IA. Abarca la latencia a nivel de modelo, el consumo de tokens por usuario y equipo, la atribución de costes por aplicación, las tasas de errores y fallbacks, y los patrones de tráfico anómalos que pueden indicar abuso o mala configuración.
La monitorización de rendimiento de aplicaciones (APM) tradicional fue diseñada para software determinista. La misma entrada, la misma salida, el mismo camino. Los LLMs son diferentes. El mismo prompt puede producir respuestas distintas, consumir cantidades de tokens muy variables y enrutarse a modelos diferentes según la configuración de tu gateway. Por eso la monitorización de API gateways estándar no lo cubre, y por eso la observabilidad de LLM es una disciplina propia.
Por Qué la Instrumentación a Nivel de SDK Falla a Escala
La mayoría de los equipos empiezan con instrumentación a nivel de SDK. Añades un wrapper al cliente Python de OpenAI, registras la solicitud y la respuesta, lo envías a tu herramienta de APM. Funciona bien para una aplicación con un modelo.
Se rompe de tres maneras a medida que escala.
Es por app, no por sistema. Obtienes visibilidad de las llamadas de la App A, pero no cómo se compara el uso de la App A con la App B o la App C. No puedes ver el consumo agregado de tokens en todo tu stack de IA desde ningún punto único.
Se salta la capa del modelo. Los logs de aplicación te muestran lo que la app envió y recibió. No te muestran qué modelo gestionó realmente la solicitud después del routing, qué devolvió el proveedor antes del filtrado de respuesta, o si se produjo un fallback a un modelo secundario.
Acumula deuda técnica rápidamente. Cada nueva aplicación necesita su propia instrumentación. Cada cambio de modelo requiere actualizaciones de instrumentación. A medida que la gestión de IA se centraliza, el enfoque por app se vuelve inmanejable.
Un AI gateway se sitúa upstream de todo esto. Cada solicitud de cada aplicación, a cada modelo, pasa por él. Un único punto de observación. Cobertura completa.
Las 6 Métricas que Importan en la Observabilidad de LLM
Esto es lo que realmente necesitas monitorizar, y por qué cada métrica es diferente en el contexto de LLM.
| Métrica | Qué Mide | Por Qué Importa |
|---|---|---|
| Latencia de solicitudes (p50/p95/p99) | Tiempo de solicitud a respuesta en cada percentil | El p99 revela la latencia de cola que las medias ocultan; un p99 lento destruye la experiencia de usuario enterprise |
| Uso de tokens por solicitud | Tokens de entrada y salida por llamada | Predice directamente el coste; una varianza grande indica que los prompts no están optimizados |
| Coste por llamada / coste por equipo | Coste en euros atribuido por aplicación, equipo o usuario | Sin esto, no puedes asignar el gasto en IA ni detectar un uso desbocado |
| Tasa de errores | Porcentaje de solicitudes que fallan o devuelven errores | Una tasa de errores creciente indica problemas del proveedor o violaciones de políticas de prompt |
| Tasa de fallback | Porcentaje de solicitudes que activan la cadena de fallback | Una tasa alta de fallback significa que tu modelo principal es poco fiable o está limitado por tasa |
| Alertas de detección de anomalías | Picos inusuales en volumen, coste o patrones de fallo | Detecta campañas de prompt injection, agentes mal configurados o sorpresas de facturación antes de que escalen |
Estas métricas solo tienen sentido cuando se agregan en todo tu stack. La tasa de errores de una sola aplicación dice poco. Tu tasa de errores en todos los modelos y equipos te dice si tienes un problema de proveedor, un problema de prompt o un problema de configuración.
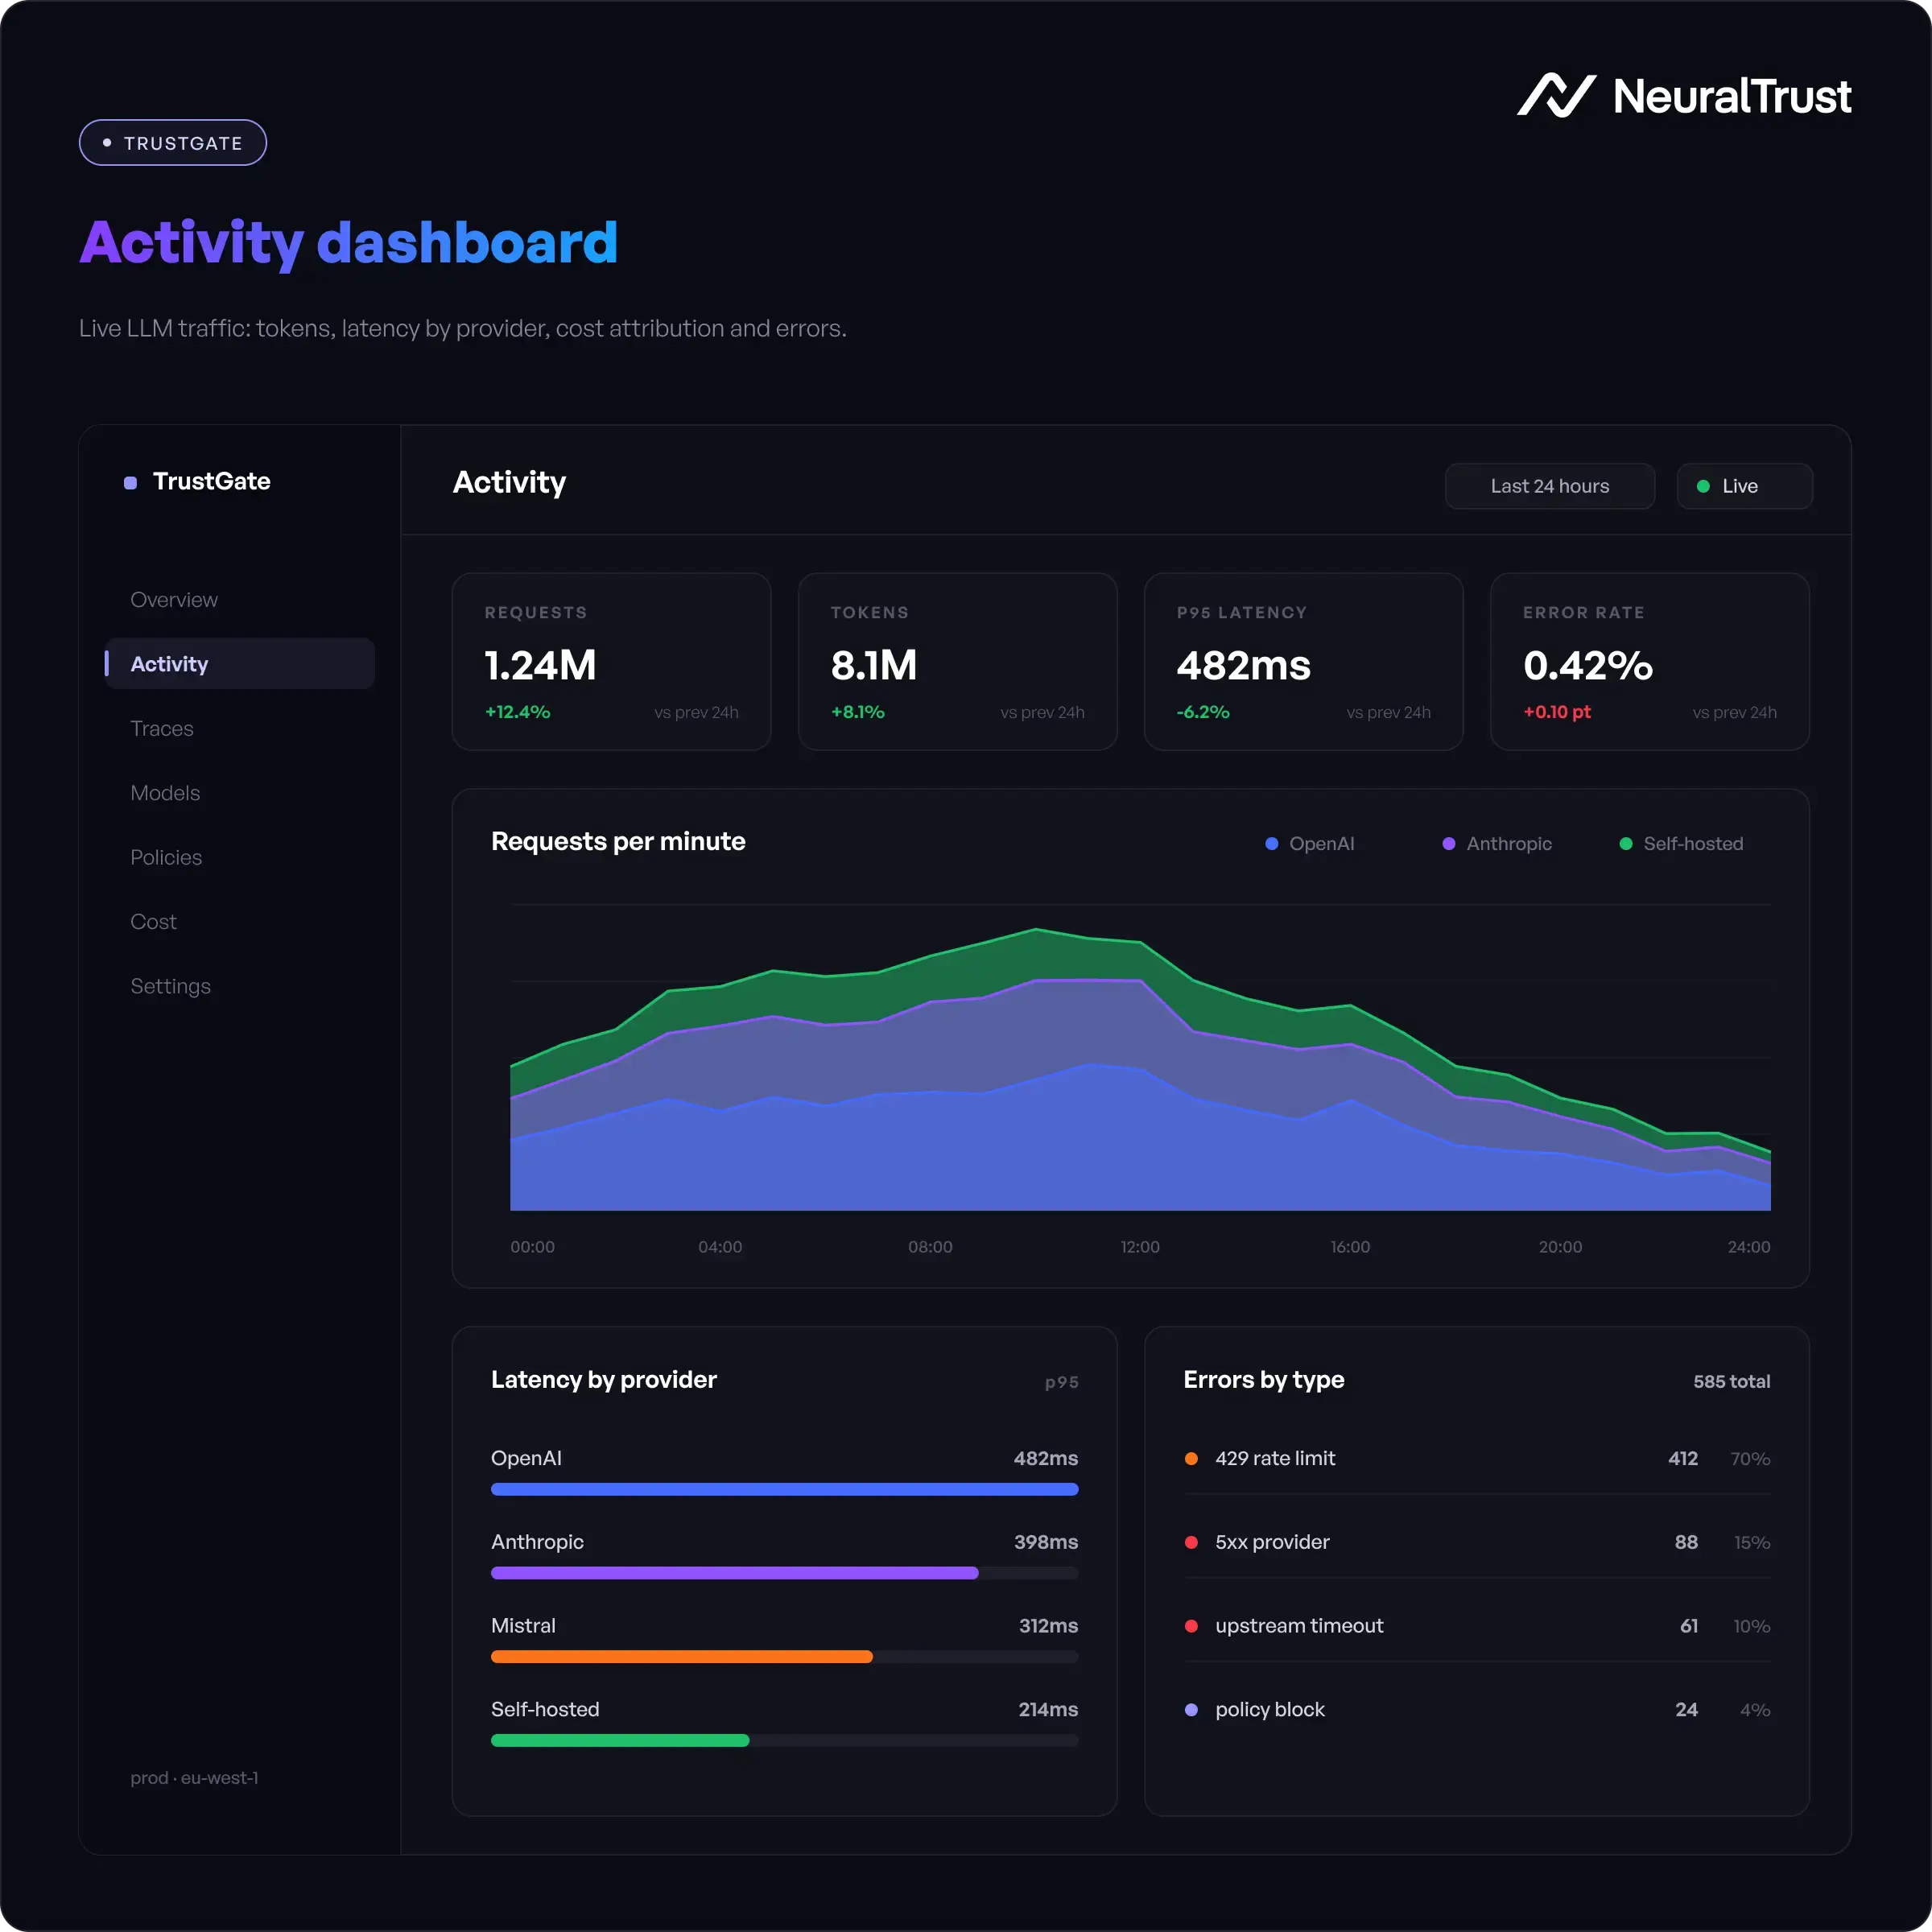
Latencia que Realmente Tiene Sentido
La mayoría de los equipos registran la latencia media. Las medias mienten.
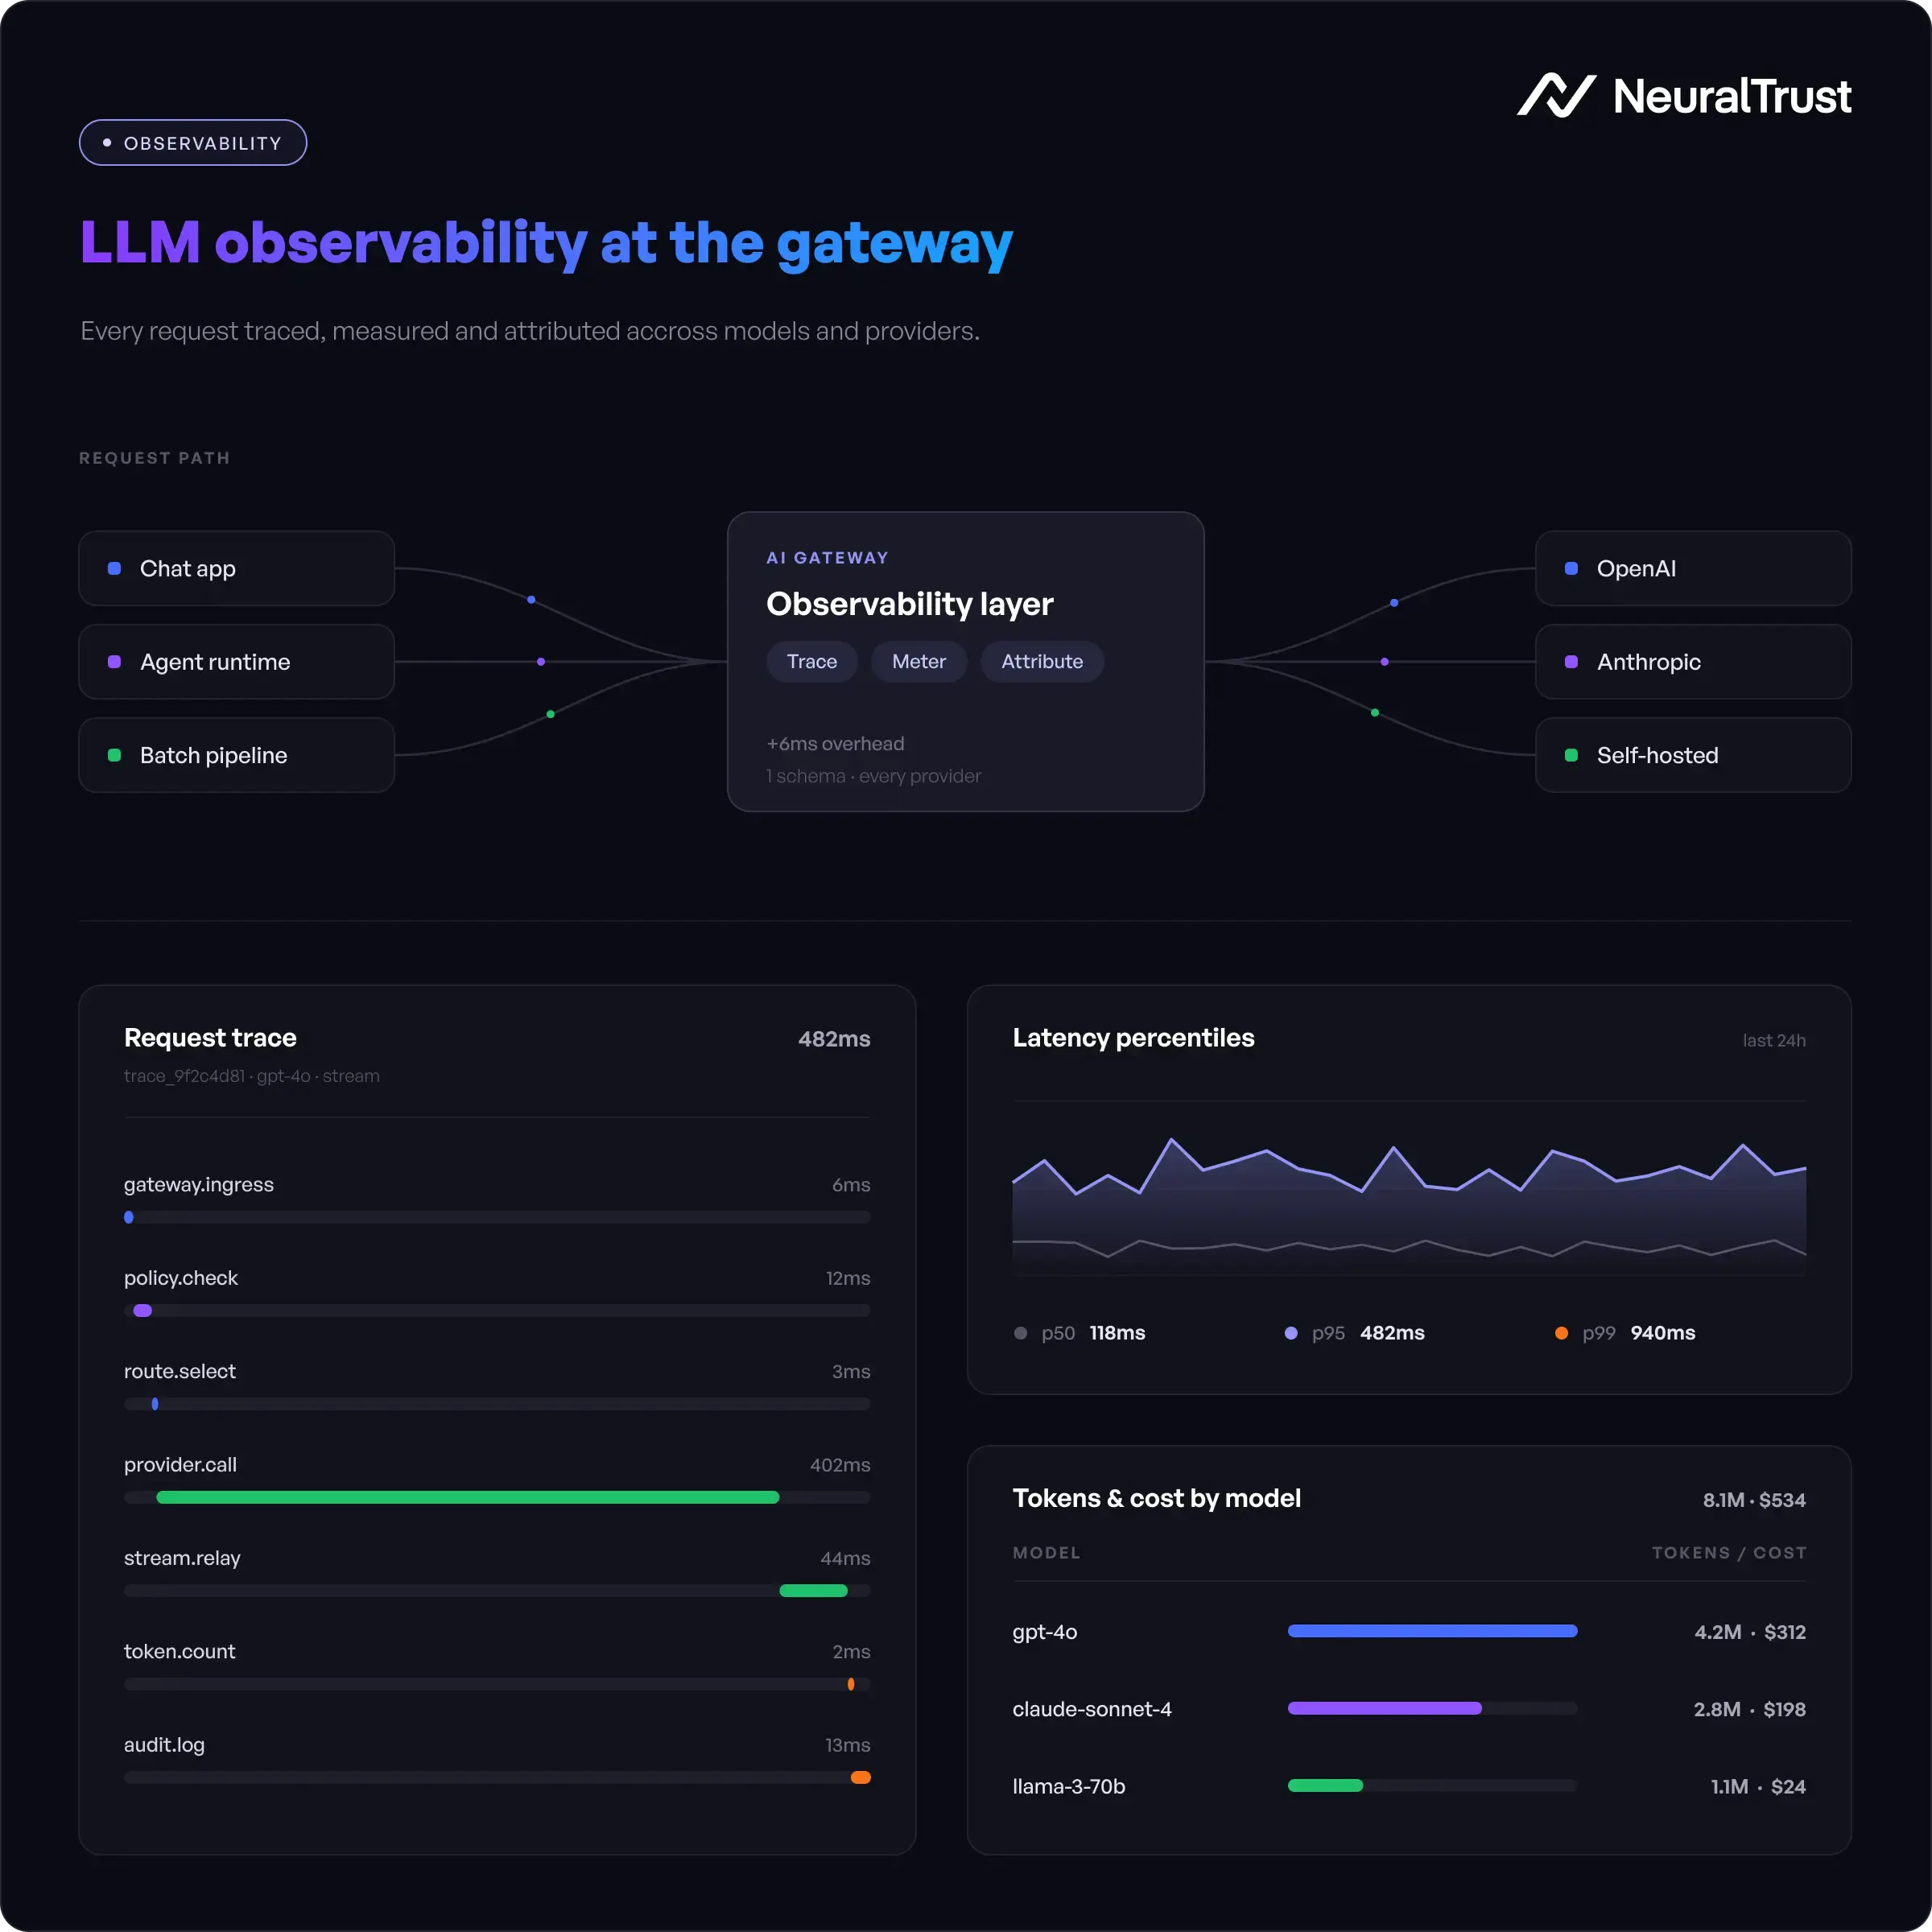
Una solicitud que tarda 200ms el 95% de las veces y 8.000ms el 5% de las veces tiene una media aceptable y una experiencia de usuario terrible. El seguimiento por percentiles, específicamente p50, p95 y p99, cuenta la historia real: el caso típico, el casi-peor y el peor real.
Registrar la latencia a nivel de proveedor revela qué modelo es lento. A nivel de equipo, revela quién ejecuta consultas complejas que inflan los tiempos de respuesta. A nivel de solicitud, ayuda a identificar qué estructuras de prompt producen la peor latencia. Mira cómo la arquitectura del AI gateway captura estos datos.
El Seguimiento de Tokens como Control de Costes
Los tokens son la unidad de coste de los LLM. La mayoría de los equipos descubren que tienen un problema de tokens en la factura de la nube. En ese momento, ya es caro.
El seguimiento de tokens a nivel de gateway te da visibilidad en tiempo real: cuántos tokens consume cada aplicación, qué usuario o equipo es el mayor consumidor y si los recuentos de tokens de solicitudes individuales están dentro de los rangos esperados. Los valores atípicos suelen ser agentes rotos ejecutándose en bucle o prompts que son dramáticamente más largos de lo previsto.
Esto alimenta directamente la optimización de costes de LLM: una vez que sabes qué solicitudes usan más tokens, puedes enrutarlas a modelos más baratos o reestructurar los prompts.
Por Qué Importa OpenTelemetry Aquí
OpenTelemetry se ha convertido en el estándar de la industria para el trazado distribuido. Proporciona un formato común para spans, trazas y métricas que funciona con los principales backends de observabilidad: Datadog, Grafana, Prometheus y otros.
Un gateway que emite trazas compatibles con OpenTelemetry significa que obtienes datos de observabilidad de LLM en el mismo formato que el resto de la observabilidad de tu infraestructura. Sin una cadena de herramientas separada para IA. Una vista unificada.
Este es el modelo de integración que escala. Tu equipo de plataforma no quiere mantener un stack de observabilidad separado para IA. Quiere las trazas de LLM en el mismo lugar que las trazas de sus servicios.
TrustGate + TrustLens: Observabilidad en la Práctica
TrustGate es el AI gateway de código abierto de NeuralTrust. A nivel del plano de datos, captura cada solicitud y respuesta: latencia, recuentos de tokens, modelo utilizado, decisión de routing, resultados de políticas, estimación de coste y la traza completa. Sin instrumentación a nivel de aplicación.
TrustLens es el producto de gestión de postura de agentes de NeuralTrust. Trabaja junto a TrustGate para proporcionar observabilidad completa del ciclo de vida de IA: no solo métricas de solicitudes individuales, sino los patrones de comportamiento de los agentes a lo largo del tiempo, incluyendo qué agentes consumen recursos inesperados, realizan llamadas API inusuales o se desvían de sus patrones de acceso esperados.
Juntos ofrecen dos capas: observabilidad a nivel de solicitud a través de TrustGate, e inteligencia de postura a nivel de agente a través de TrustLens.
Ver TrustGate en GitHub | Página de producto TrustGate | Página de producto TrustLens
Prueba TrustGate Gratis
Sin llamada de ventas. Sin tarjeta de crédito. Regístrate, despliega TrustGate en tu propio entorno y ve todo tu tráfico de LLM en tiempo real en cuestión de minutos.
Empieza gratis con TrustGate hoy
La Serie Completa de AI Gateway
- Qué es un AI Gateway: Guía Completa
- AI Gateway vs MCP Gateway
- Seguridad en AI Gateway: Protegiendo el Tráfico de LLM
- Arquitectura de un AI Gateway: Cómo Funciona por Dentro
- Cómo un AI Gateway Reduce los Costes de LLM
- AI Gateways vs API Gateways: Las Diferencias
- Gestión Centralizada de IA a Escala
- AI Gateways y Soberanía de Datos
- Mejores AI Gateways en 2026
- AI Gateway vs Guardrails: Lo que Realmente Necesitas
FAQs acerca de cómo un AI Gateway solventa la observabilidad de LLMs
1. ¿Qué es la observabilidad de LLM?
La observabilidad de LLM es la práctica de monitorizar en tiempo real cada solicitud, respuesta, token y coste que fluye por tus aplicaciones de IA. Abarca la latencia a nivel de modelo y proveedor, el consumo de tokens por equipo o usuario, la atribución de costes por aplicación, las tasas de errores y fallbacks, y la detección de anomalías en patrones de tráfico inusuales.
2. ¿Cómo se monitoriza el rendimiento de LLM en producción?
El enfoque más completo es la monitorización a nivel de gateway: cada solicitud de LLM pasa por el gateway, que captura automáticamente la latencia, el uso de tokens, el modelo utilizado, la decisión de routing y los resultados de políticas. La instrumentación de SDK a nivel de aplicación solo cubre apps individuales y no ofrece visibilidad entre modelos y equipos.
3. ¿Qué métricas debo monitorizar en aplicaciones de LLM?
Las seis métricas principales son: latencia de solicitudes en p50/p95/p99, uso de tokens por solicitud, coste por llamada atribuido por equipo o usuario, tasa de errores, tasa de fallback (con qué frecuencia las solicitudes activan la cadena de fallback) y alertas de anomalías para picos inusuales de volumen o coste. Monitoriza todas a nivel agregado, no solo por aplicación.
4. ¿Cómo proporciona observabilidad un AI gateway?
Un AI gateway se sitúa entre todas tus aplicaciones y todos tus proveedores de LLM. Cada solicitud pasa por él, por lo que captura la imagen completa: quién llamó a qué modelo, cuánto tardó, cuántos tokens usó, cuánto costó y si activó alguna política. Sin cambios en las aplicaciones.
5. ¿Cuál es la diferencia entre la observabilidad de LLM y el APM tradicional?
El APM tradicional fue diseñado para software determinista: la misma entrada, la misma salida. Los LLMs son no deterministas. Los recuentos de tokens varían, las respuestas varían, los modelos pueden cambiar mediante routing y los costes son por consumo, no fijos. La observabilidad de LLM rastrea estas dimensiones específicas que las herramientas de APM estándar no fueron diseñadas para capturar.
Sobre el Autor
Roger Howroyd es Head of Global SEO and AI en NeuralTrust, donde lidera la estrategia de búsqueda de la empresa en SEO, AEO, GEO y optimización para LLM. Está especializado en búsqueda impulsada por IA, estrategia de contenido y SEM. Conecta en LinkedIn.
NeuralTrust es una plataforma de seguridad para agentes de IA reconocida en el Gartner Hype Cycle for Application Security 2026, la Guía de Mercado de Gartner para AI Gateways y el KuppingerCole Leadership Compass for Generative AI Defense. Certificación ISO 27001. Sede en Barcelona.