¿Cómo se asegura el tráfico de LLM y agentes de IA en producción?
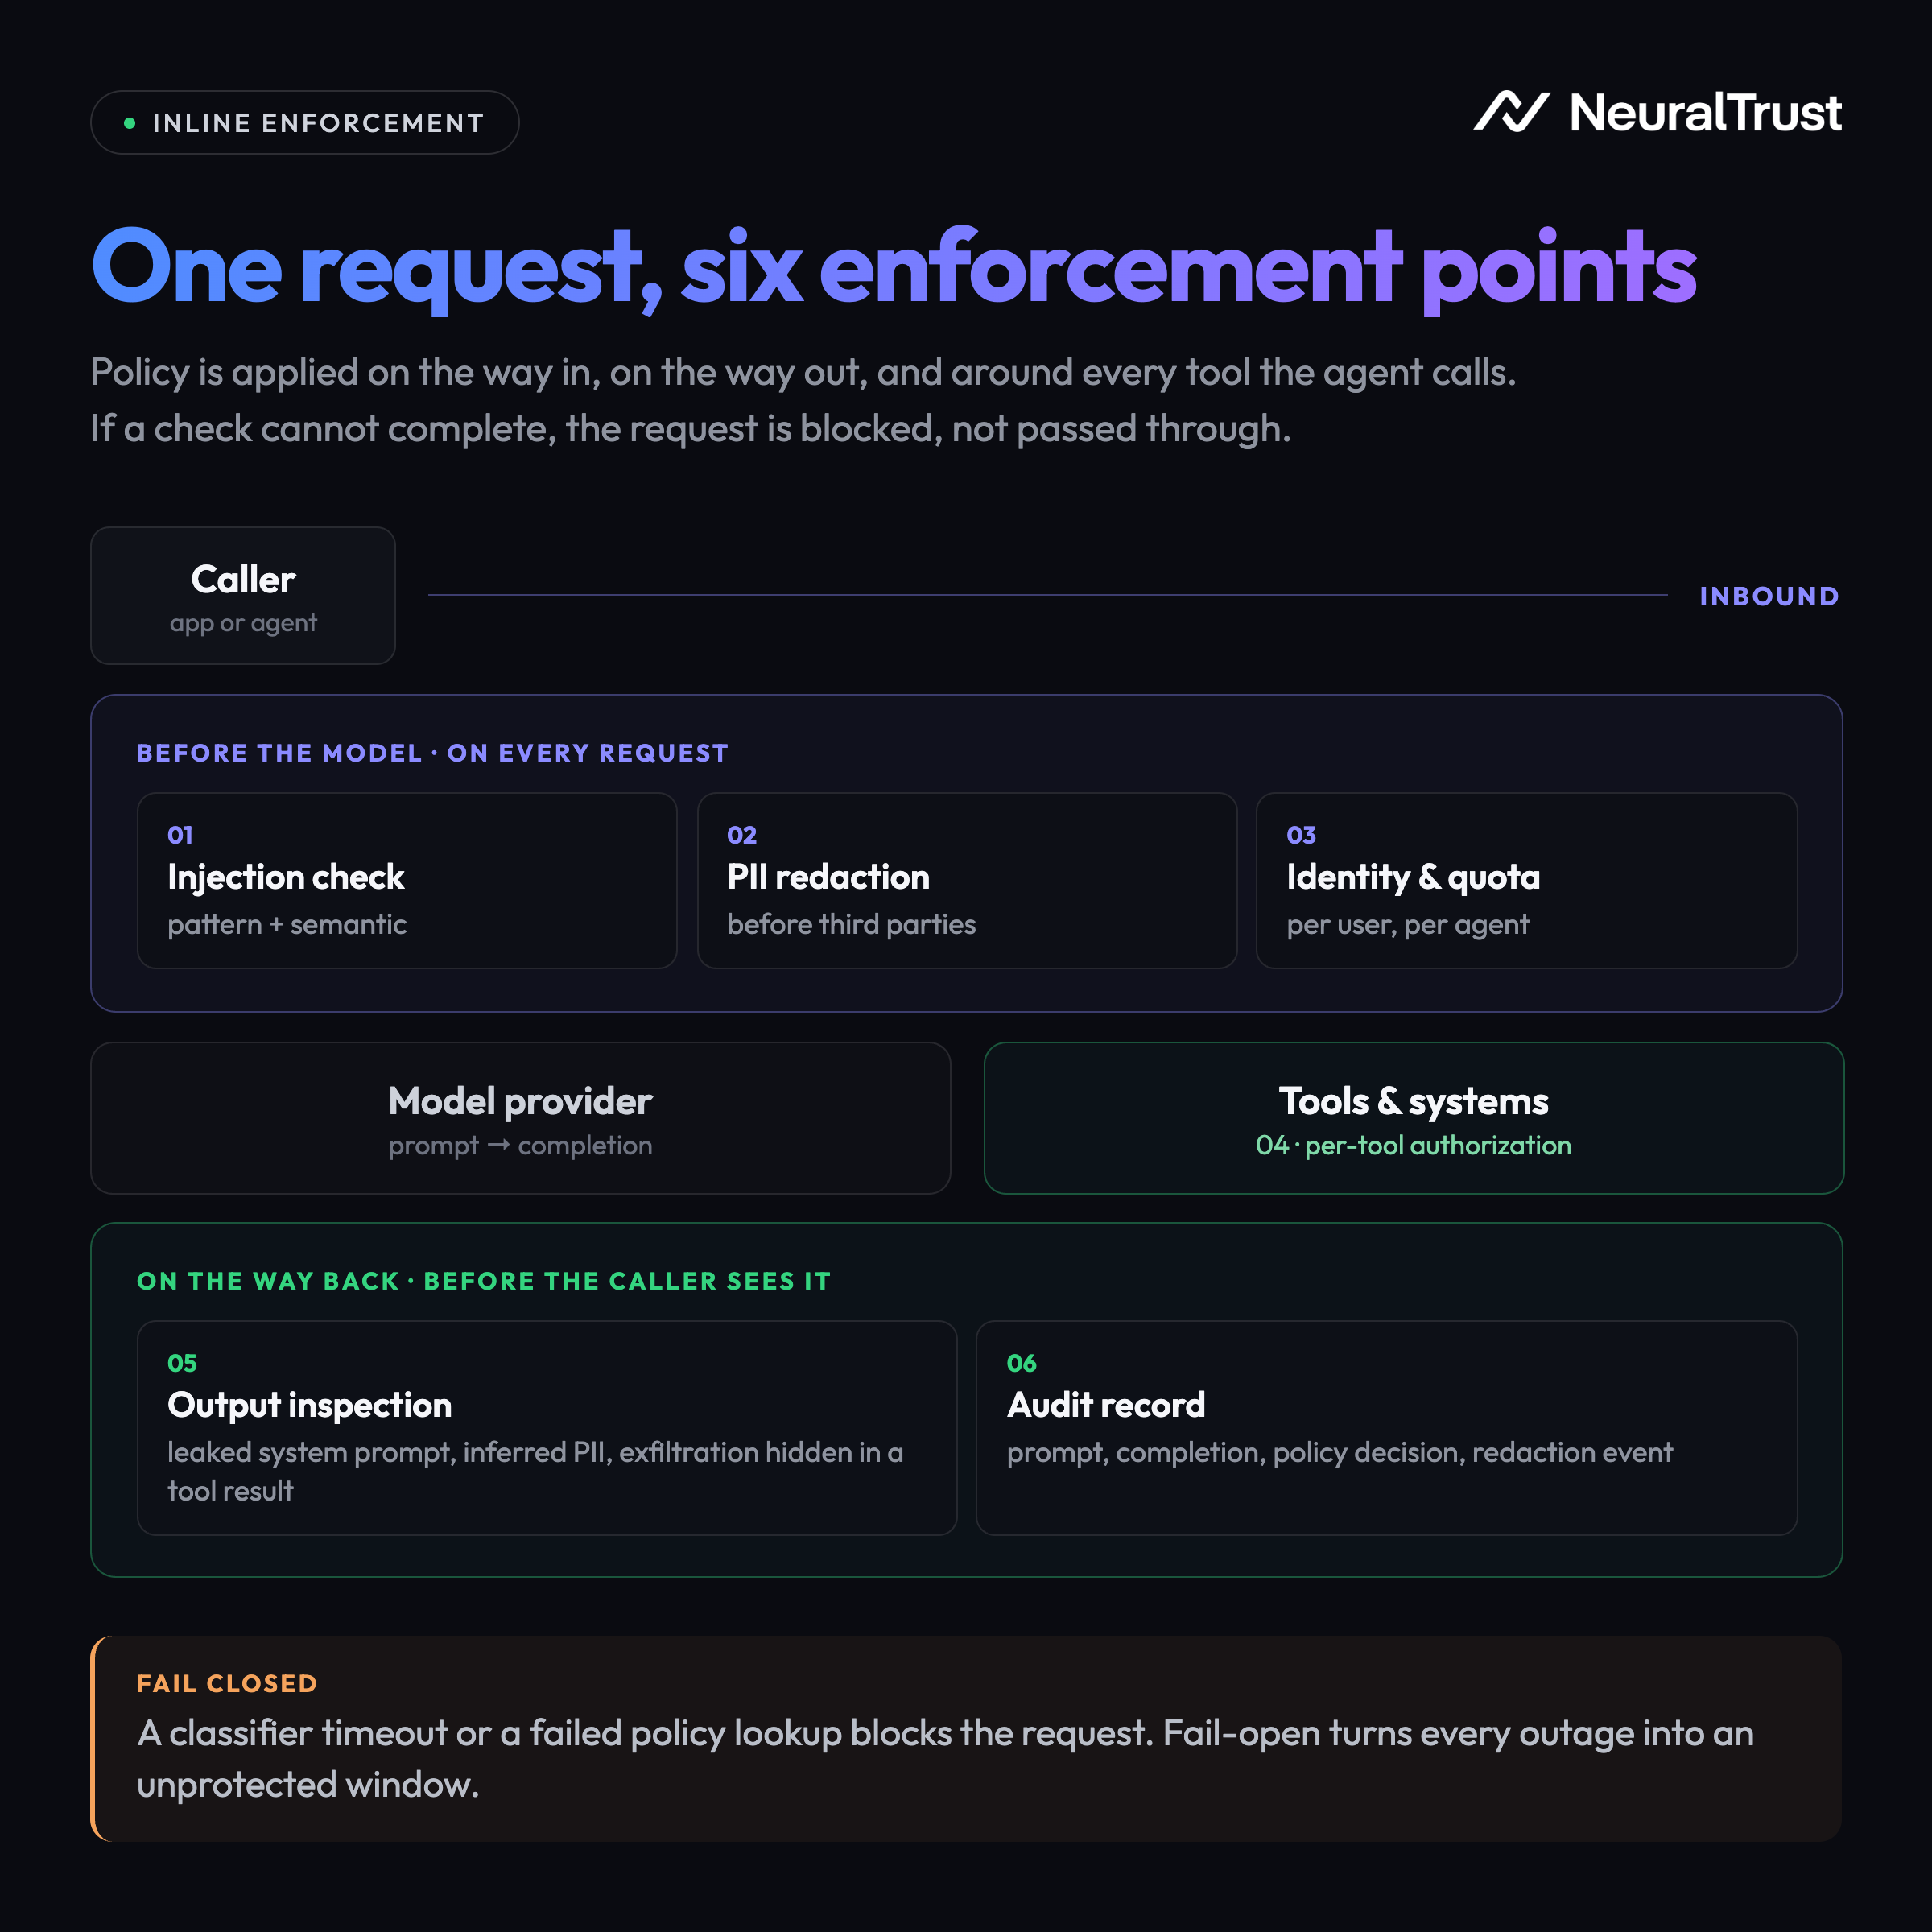
Un AI gateway protege el tráfico de LLM y agentes inspeccionando prompts, llamadas a herramientas y respuestas en tiempo real, aplicando controles de acceso sobre qué datos y acciones puede alcanzar un agente, detectando y redactando datos sensibles, y manteniendo un registro de auditoría completo de cada interacción de modelo y agente. En lugar de confiar en el proveedor del modelo o en la capa de aplicación para detectar abusos después de que ocurren, el gateway se sitúa en línea en cada solicitud, llamada a herramienta y respuesta, aplicando la política de seguridad antes de que un prompt llegue al modelo y antes de que se ejecute la acción de un agente.
Esto importa más con los agentes que con el tráfico de LLM simple, porque un agente no solo genera texto, sino que realiza acciones: llama a herramientas, consulta sistemas internos y encadena múltiples pasos de forma autónoma. Una carga maliciosa puede estar incrustada en lenguaje natural, oculta dentro de un documento recuperado, o plantada en la salida de una herramienta, y un agente comprometido puede convertir eso en acceso no autorizado a datos o en un efecto real en el mundo. Nada de esto es algo que un firewall de aplicaciones web (WAF) tradicional o una API gateway estén diseñados para analizar. Asegurar el tráfico de LLM y agentes en producción requiere un punto de control que entienda el contenido semántico y el comportamiento del agente, no solo encabezados, métodos y umbrales de velocidad.
TL;DR - Conclusiones clave
- Los WAF tradicionales y las API gateways inspeccionan la sintaxis (encabezados, tamaño del payload, firmas conocidas). No pueden inspeccionar el significado de un prompt ni la intención detrás de la llamada a una herramienta por parte de un agente, que es donde viven la mayoría de los ataques específicos de LLM y agentes.
- Un AI gateway es el punto de aplicación natural para la seguridad de LLM y agentes porque cada prompt, llamada a herramienta y finalización ya pasan por él.
- Los agentes elevan las apuestas: un prompt comprometido ya no solo produce texto malo, puede desencadenar llamadas a herramientas no autorizadas, acceso a datos o acciones posteriores, razón por la cual la agencia excesiva es uno de los riesgos que un gateway debe contener activamente, no solo registrar.
- El OWASP Top 10 para aplicaciones LLM (2025) ofrece un modelo de amenazas estructurado — inyección de prompts (LLM01), divulgación de información sensible (LLM02), agencia excesiva (LLM06) y consumo ilimitado (LLM10) son las que un gateway está mejor posicionado para detener.
- Controles principales del gateway: detección de inyección de prompts, detección y redacción de PII, controles de acceso a nivel de token y herramienta para agentes, limitación de velocidad, registro de auditoría completo, comportamiento de fallo cerrado y aplicación de residencia de datos.
- Según el Informe de Costo de una Filtración de Datos 2025 de IBM, el 97% de las organizaciones que sufrieron un incidente de seguridad relacionado con IA no contaban con controles de acceso de IA, una brecha de gobernanza que los gateways están diseñados para cerrar.
- La Ley de IA de la UE (Artículos 12, 19 y 26) exige el registro automático de eventos y el mantenimiento de registros para sistemas de IA de alto riesgo, capacidades que un AI gateway puede ofrecer de forma predeterminada.
- TrustGate (el AI gateway) y TrustGuard (gobernanza y detección de amenazas) son complementarios, no intercambiables: uno aplica la política en línea, el otro evalúa y monitorea el riesgo.
Por qué los WAF y las API gateways tradicionales no pueden proteger el tráfico de LLM y agentes
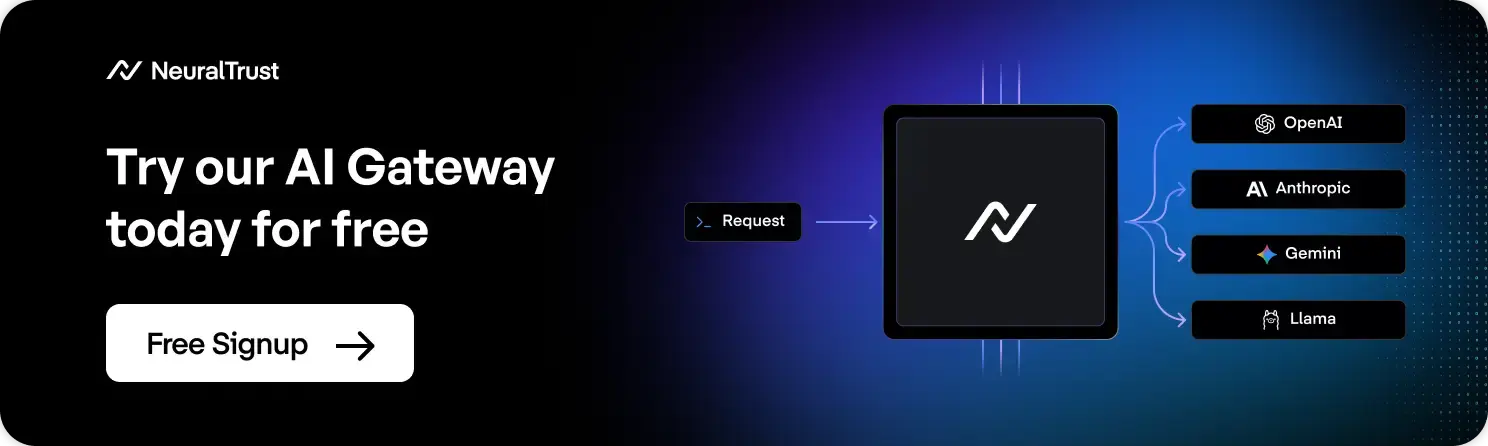
Los firewalls de aplicaciones web y las API gateways fueron construidos para un mundo de solicitudes estructuradas: endpoints conocidos, esquemas fijos, y ataques que se manifiestan como sintaxis malformada, fragmentos de SQL, etiquetas de script, payloads de tamaño excesivo. Son excelentes en ese trabajo. Son la herramienta equivocada para el tráfico de LLM y agentes porque la superficie de ataque se ha desplazado de la sintaxis a la semántica, y, con los agentes, de una única solicitud a una cadena de decisiones autónomas.
Un ataque de inyección de prompts no parece malicioso a nivel de protocolo. Es inglés simple (o cualquier otro idioma) instruyendo al modelo a ignorar su prompt de sistema, exfiltrar contexto o llamar a una herramienta que no debería. Un WAF ve un payload JSON bien formado y lo deja pasar. Con un agente, el riesgo se agrava: la instrucción inyectada no solo produce una respuesta de texto mala, puede llegar a ejecutarse, una llamada a herramienta, una consulta a base de datos, un correo electrónico saliente, porque el agente está diseñado para actuar sobre lo que lee, incluido contenido plantado por un atacante dentro de un documento, una página web o la propia salida de una herramienta. La exposición de datos sensibles sigue el mismo patrón: un agente que gestiona un ticket de soporte podría necesitar legítimamente leer un número de tarjeta de crédito para resolver un caso, pero nada en esa solicitud activa una regla basada en firmas. Y debido a que los sistemas agénticos encadenan múltiples llamadas a herramientas e invocaciones de modelo para completar una tarea, un solo paso comprometido puede desencadenar una secuencia de acciones no autorizadas, algo que la limitación de velocidad por sí sola no detectará, porque el volumen de solicitudes parece completamente normal.
Esta es la brecha que un AI gateway está diseñado a cerrar. Si eres nuevo en el concepto, nuestra guía sobre qué es un AI gateway cubre la arquitectura con más profundidad; este artículo se centra específicamente en la capa de seguridad tanto para el tráfico de LLM como de agentes.
El AI Gateway como punto de control de seguridad principal
Cada prompt enviado a un modelo, cada llamada a herramienta que hace un agente, y cada finalización devuelta ya pasan por el gateway si hay uno desplegado, lo que lo convierte en el lugar natural para aplicar la política de seguridad, en lugar de acoplar verificaciones a la capa de aplicación o confiar en los propios filtros del proveedor del modelo. Centralizar la aplicación en el gateway significa que la política se aplica de manera consistente en todas las aplicaciones, agentes, equipos y modelos, en lugar de reimplementarse (e inevitablemente desviarse) dentro de cada servicio que llama a un LLM.
Un gateway que cumple bien su función de seguridad debería poder:
- Inspeccionar cada prompt, llamada a herramienta y finalización en busca de intentos de inyección, violaciones de política y contenido sensible, no solo registrarlos después del hecho.
- Aplicar controles de acceso a nivel de token, usuario, agente y aplicación, para que una credencial comprometida o un agente manipulado no otorguen acceso general a todos los modelos, herramientas y conjuntos de datos.
- Redactar PII y otros datos sensibles antes de que lleguen al modelo o antes de que una finalización llegue al llamador.
- Limitar la velocidad por usuario, aplicación y endpoint para prevenir tanto el abuso como el costo descontrolado por consumo ilimitado.
- Registrar cada interacción en un rastro de auditoría resistente a manipulaciones, satisfaciendo tanto las necesidades de respuesta a incidentes como las de cumplimiento.
- Fallar cerrado, cuando una verificación de política no puede completarse (tiempo de espera agotado, error ascendente, clasificación ambigua), el valor predeterminado seguro es bloquear la solicitud, no dejarla pasar.
Aquí es también donde un AI gateway se diferencia de una biblioteca de guardrails acoplada a una sola aplicación: los guardrails se ejecutan dentro del propio proceso de la aplicación y deben integrarse por servicio, mientras que un gateway aplica la política de forma centralizada, frente a cada aplicación que habla con un modelo. Cubrimos esa distinción directamente en AI gateway vs. guardrails.
Mapeo de las amenazas del OWASP LLM Top 10 a los controles del gateway
El OWASP Top 10 para aplicaciones LLM es lo más parecido a un modelo de amenazas estándar que tiene la industria para la seguridad de LLM, y es una lente útil para evaluar si un gateway realmente cubre los riesgos que importan. No todas las amenazas de la lista son algo que un gateway pueda resolver por sí solo, algunas requieren cambios en el entrenamiento del modelo o en la lógica de la aplicación, pero varias se sitúan directamente en la ruta de inspección del gateway.
| Amenaza (ID OWASP) | Riesgo | Control del Gateway |
|---|---|---|
| Inyección de prompts (LLM01) | Una entrada manipulada anula las instrucciones del sistema, provocando que el modelo filtre datos o realice acciones no autorizadas | Inspección de prompts en tiempo real y detección de inyecciones antes de que la solicitud llegue al modelo |
| Divulgación de información sensible (LLM02) | PII, credenciales o datos propietarios aparecen en prompts o finalizaciones | Detección y redacción de PII aplicada tanto a los prompts entrantes como a las respuestas salientes |
| Agencia excesiva (LLM06) | A un agente se le otorga más acceso a herramientas, permisos o autonomía de la que la tarea requiere, permitiendo que un agente manipulado realice acciones no deseadas | Controles de acceso a nivel de token y herramienta que limitan a qué herramientas, endpoints y fuentes de datos puede acceder un agente o solicitud determinados |
| Filtración del prompt de sistema (LLM07) | Un atacante extrae el prompt de sistema para realizar ingeniería inversa de los guardrails | Inspección de salida que bloquea finalizaciones que se asemejan a contenido del prompt de sistema |
| Consumo ilimitado (LLM10) | Un volumen de solicitudes incontrolado provoca sobrecostos o condiciones de denegación de servicio | Limitación de velocidad y aplicación de cuotas por usuario, aplicación y endpoint de modelo |
Dos amenazas que vale la pena señalar como adyacentes al gateway en lugar de resueltas por él: los riesgos de cadena de suministro (LLM03) y el envenenamiento de datos y modelos (LLM04) tienen que ver en gran medida con lo que entra en el entrenamiento y el ajuste fino, lo cual se sitúa aguas arriba del tráfico en tiempo de ejecución. Un gateway aún puede ayudar, por ejemplo, aplicando qué modelos y versiones tiene permitido llamar una aplicación, pero no es un sustituto de los controles de cadena de suministro y gobernanza de datos más atrás en el pipeline.
Capacidades de seguridad principales, en la práctica
1. Defensa contra la inyección de prompts: la detección debe ejecutarse en cada solicitud, en línea, con una latencia lo suficientemente baja como para no degradar la experiencia del usuario. Esto típicamente combina detección basada en patrones para técnicas de inyección conocidas con clasificación semántica para las nuevas, y la decisión, permitir, marcar o bloquear, ocurre antes de que el prompt llegue al modelo.
2. Detección y redacción de PII: esto se ejecuta en ambas direcciones. En sentido entrante, el gateway puede eliminar o enmascarar campos sensibles antes de que lleguen a un proveedor de modelos externo, algo importante cuando los términos de manejo de datos del proveedor no son totalmente confiables, o cuando los requisitos regulatorios prohíben enviar ciertas categorías de datos al exterior. En sentido saliente, la misma inspección detecta los casos en que un modelo reconstruye o infiere PII que no se le proporcionó directamente.
3. Controles de acceso a nivel de token y herramienta. el acceso debe delimitarse por clave API o identidad de servicio hasta el nivel de qué modelos, qué herramientas y qué fuentes de datos puede alcanzar un llamador determinado, o un agente determinado, no una credencial de todo o nada compartida en toda una aplicación. Para los agentes específicamente, esto significa definir permisos por agente: qué herramientas puede llamar, qué endpoints puede alcanzar, y qué acciones requieren un humano en el proceso antes de ejecutarse. Esta es precisamente la brecha que señala la investigación de IBM sobre filtraciones de datos de 2025: las organizaciones que sufrieron un incidente relacionado con IA carecían abrumadoramente de esta capa de control.
4. Limitación de velocidad: más allá de prevenir el abuso, la limitación de velocidad es un mecanismo de control de costos. Los bucles agénticos descontrolados, un agente atascado volviendo a llamar a la misma herramienta, o encadenando pasos indefinidamente porque una condición de parada nunca se activa, pueden generar miles de llamadas innecesarias a modelos y herramientas en minutos; las cuotas por usuario, por agente y por aplicación limitan el radio de impacto.
5. Registro de auditoría completo: cada prompt, finalización, decisión de política y evento de redacción debe registrarse de manera que respalde tanto las investigaciones de seguridad como los informes de cumplimiento, ver la sección de la Ley de IA de la UE más abajo para entender por qué este requisito específico se está volviendo no negociable para muchas implementaciones.
6. Comportamiento de fallo cerrado: cuando una verificación de seguridad no puede completarse, el servicio de clasificación agota el tiempo de espera, falla una búsqueda de política, el gateway debería bloquear la solicitud en lugar de dejarla pasar. Las configuraciones de fallo abierto convierten silenciosamente cada interrupción en una brecha de seguridad.
7. Aplicación de residencia de datos: para organizaciones que operan bajo requisitos regionales de protección de datos, el gateway puede aplicar a qué endpoints y regiones de modelo puede enrutarse una solicitud determinada, evitando que los datos salgan de una jurisdicción aprobada. Profundizamos más en esto en AI gateways y soberanía de datos.
Ejemplo: Una política de seguridad en TrustGate
A continuación se muestra un ejemplo simplificado de cómo se ve una configuración de política de seguridad a nivel de gateway, combinando la detección de inyección de prompts, la redacción de PII, los controles de acceso a herramientas de agentes y un límite de velocidad en una única política aplicada:
Los detalles variarán según la plataforma, pero el patrón es consistente: la política es declarativa, se aplica en el gateway en lugar de en el código de la aplicación, y por defecto bloquea cuando una verificación falla.
El cumplimiento normativo está avanzando — y el registro es el hilo común
Dos desarrollos hacen que el registro de auditoría y los controles de acceso sean menos una buena práctica y más un requisito.
Primero, el costo de equivocarse en la seguridad de la IA ahora es medible. El Informe de Costo de una Filtración de Datos 2025 de IBM encontró que el 13% de las organizaciones reportó una filtración que involucraba un modelo o aplicación de IA, y de esas, el 97% carecía de controles de acceso de IA adecuados. El mismo informe encontró que el 60% de los incidentes relacionados con IA provocaron el compromiso de datos y el 31% causó interrupciones operativas, y que las organizaciones que usan IA y automatización extensivamente en sus operaciones de seguridad ahorraron un promedio de 1.9 millones de dólares por filtración y redujeron el ciclo de vida de la filtración en 80 días. El patrón es consistente: los sistemas de IA no gobernados sufren filtraciones con más frecuencia, y cuestan más cuando ocurren.
Segundo, la regulación está formalizando lo que significa una "buena gobernanza". La Ley de IA de la UE exige que los sistemas de IA de alto riesgo admitan el registro automático de eventos durante toda la vida útil del sistema (Artículo 12), obliga a los proveedores a conservar esos registros (Artículo 19), y exige a los implementadores mantener los registros durante al menos seis meses y cooperar con las autoridades competentes cuando se les solicite (Artículo 26). Un AI gateway que registra cada prompt, finalización y decisión de política por defecto está bien posicionado para satisfacer este requisito sin necesidad de que cada aplicación posterior implemente el registro por separado.
TrustGate y TrustGuard: Dos capas, no un producto
Vale la pena ser preciso sobre dónde se sitúan la aplicación y la evaluación, porque las dos a menudo se confunden.
- TrustGate es el AI gateway, se sitúa en línea en cada solicitud y cada llamada a herramienta de un agente, aplicando las políticas descritas anteriormente en tiempo real: bloqueando la inyección de prompts, redactando PII, aplicando controles de acceso y permisos de herramientas, y produciendo el registro de auditoría.
- TrustGuard opera en la capa de gobernanza y detección de amenazas, evaluando el riesgo de los agentes, ejecutando pruebas adversariales contra flujos de trabajo agénticos, y proporcionando la visibilidad más amplia que informa lo que las políticas de TrustGate deberían ser en realidad.
En la práctica, los dos son complementarios: TrustGuard te dice qué herramientas y acciones nunca debería tener permitidas un agente, TrustGate lo aplica en cada solicitud.
FAQs acerca de la seguridad de AI Gateways
1. ¿Cómo previene un AI gateway la inyección de prompts?
Inspecciona cada prompt, y cada llamada a herramienta que hace un agente, en línea, antes de que la solicitud llegue al modelo o se ejecute la herramienta, usando una combinación de detección basada en patrones para técnicas de inyección conocidas y clasificación semántica para las nuevas, incluidas las inyecciones plantadas en documentos recuperados o salidas de herramientas. Las solicitudes clasificadas como maliciosas se bloquean (o se marcan, según la política) en lugar de dejarse pasar, y debido a que esto ocurre en el gateway, la misma protección se aplica en todas las aplicaciones y agentes que se enrutan a través de él, no solo en los que implementaron sus propias verificaciones.
Artículo relacionado: Cómo configurar la detección de inyección de prompts para tu stack de LLM
2. ¿Puede un AI gateway detectar PII?
Sí. La detección de PII se ejecuta tanto en los prompts entrantes como en las finalizaciones salientes, identificando categorías como correos electrónicos, números de teléfono, números de tarjetas de crédito e identificaciones gubernamentales, y redactando o bloqueando el contenido según la política. Esto protege contra el envío de datos sensibles a un proveedor de modelos externo y contra que un modelo revele PII que infirió en lugar de que se le haya proporcionado directamente.
3. ¿Qué es el fallo cerrado en un AI gateway?
Fallo cerrado significa que cuando una verificación de seguridad no puede completarse, un servicio de clasificación agota el tiempo de espera, falla una búsqueda de política, el gateway bloquea la solicitud por defecto en lugar de dejarla pasar. La alternativa, fallo abierto, prioriza la disponibilidad sobre la seguridad y convierte cualquier interrupción en el pipeline de verificación en una ventana desprotegida. Para el tráfico de LLM en producción que maneja datos sensibles, el fallo cerrado es el valor predeterminado más seguro.
4. ¿En qué se diferencia un AI gateway de un WAF?
Un WAF inspecciona el tráfico a nivel de sintaxis, encabezados, estructura del payload, firmas de ataques conocidas, lo cual funciona bien para exploits web convencionales como la inyección SQL o el XSS. Un AI gateway inspecciona el tráfico a nivel semántico, comprendiendo el significado de un prompt o finalización lo suficientemente bien como para detectar intentos de inyección, contenido sensible o violaciones de política expresadas en lenguaje natural. Los dos no son mutuamente excluyentes: muchas implementaciones en producción mantienen un WAF frente a la capa de aplicación y añaden un AI gateway específicamente para el tráfico de LLM que un WAF no puede analizar de manera significativa.
Artículos relacionados
- ¿Qué es un AI Gateway? Guía completa 2026
- Seguridad del AI Gateway: Cómo proteger el tráfico de LLM en producción
- Arquitectura del AI Gateway: Cómo funciona por dentro
- Cómo un AI Gateway resuelve la observabilidad de LLM
- Cómo un AI Gateway reduce los costos de LLM
- Cómo un AI Gateway resuelve la gobernanza de IA para empresas
- Cómo elegir un AI Gateway: Guía del comprador empresarial (2026)
- AI Gateway para IA agéntica: Asegurando flujos de trabajo multiagente
- Cómo desplegar un AI Gateway autoalojado (paso a paso)
Sobre el autor
Alessandro Pignati es Investigador principal de seguridad de IA en NeuralTrust, donde lidera la investigación sobre seguridad de IA y agentes, avanzando en técnicas para evaluar y asegurar grandes modelos de lenguaje y sistemas de IA autónomos. Se especializa en aprendizaje automático adversarial, red teaming de IA, seguridad de LLM y seguridad de IA, contribuyendo al desarrollo de IA segura y confiable.
NeuralTrust es una plataforma de seguridad para agentes de IA, reconocida en la Guía de Mercado 2025 de Gartner para AI Gateways y Guardian Agents, y en el KuppingerCole Leadership Compass 2025 para Defensa de IA Generativa. Con sede en Barcelona y certificación ISO 27001.