Arquitectura de AI Gateway: Un AI gateway procesa cada solicitud de LLM a través de cinco capas secuenciales: autenticación, routing, inspección de seguridad, llamada al modelo y logging. El motor de routing decide qué modelo gestiona cada solicitud utilizando balanceo de carga, cadenas de fallback y reglas basadas en coste. Una arquitectura split-plane separa la gestión de políticas del manejo del tráfico, manteniendo tus datos en tu propio entorno.
TL;DR - Puntos Clave
- Cada solicitud a través de un AI gateway pasa por cinco capas en secuencia: autenticación, routing, inspección de seguridad, llamada upstream y logging
- El motor de routing gestiona: el balanceo de carga, las cadenas de fallback y las decisiones basadas en coste, dirigiendo cada solicitud al modelo correcto en milisegundos
- La separación entre el plano de control y el plano de datos determina si el tráfico de LLM abandona tu infraestructura alguna vez
- El diseño split-plane de TrustGate mantiene el plano de datos completamente dentro de tu entorno; el plano de control gestiona las políticas sin tocar tu tráfico
La mayoría de los ingenieros tratan un AI gateway como una caja negra. El tráfico entra, las respuestas salen. Pero la arquitectura interior determina si realmente puedes controlar tu stack de IA en producción. Este artículo recorre cada capa, desde la autenticación hasta el registro de auditoría. Salta directamente a la sección del motor de routing si eso es lo que buscas.
El Problema del que Nadie Habla Hasta que Se Rompe
Llevas seis meses en producción. Las funcionalidades de IA funcionan. Entonces tu CTO pregunta: ¿cuánto nos cuesta cada usuario? ¿Qué modelo gestionó esa solicitud fallida la semana pasada? ¿Algún prompt del equipo de atención al cliente incluyó PII?
Sin respuestas. No porque seas mal ingeniero. Sino porque ibas rápido y la capa de control parecía algo que añadir después.
Ahora la estás añadiendo con tráfico en directo.
Este es el patrón habitual. La capa de control se salta y luego se reconstruye bajo presión. Construirla bien desde el principio significa entender cómo funciona realmente.
¿Qué es un AI Gateway?
Un AI gateway es un AI router: una capa de proxy inverso diseñada específicamente para el tráfico de LLM. Se sitúa entre tus aplicaciones y los proveedores de modelos que utilizas. Cada solicitud pasa por él.
A diferencia de un API gateway estándar, entiende el payload. No se limita a reenviar tráfico HTTP. Lee los prompts, inspecciona las respuestas, enruta según la capacidad del modelo y registra cada token en cada paso.
La arquitectura interior es lo que hace posible todo eso.
¿Cómo Procesa un AI Gateway una Solicitud?
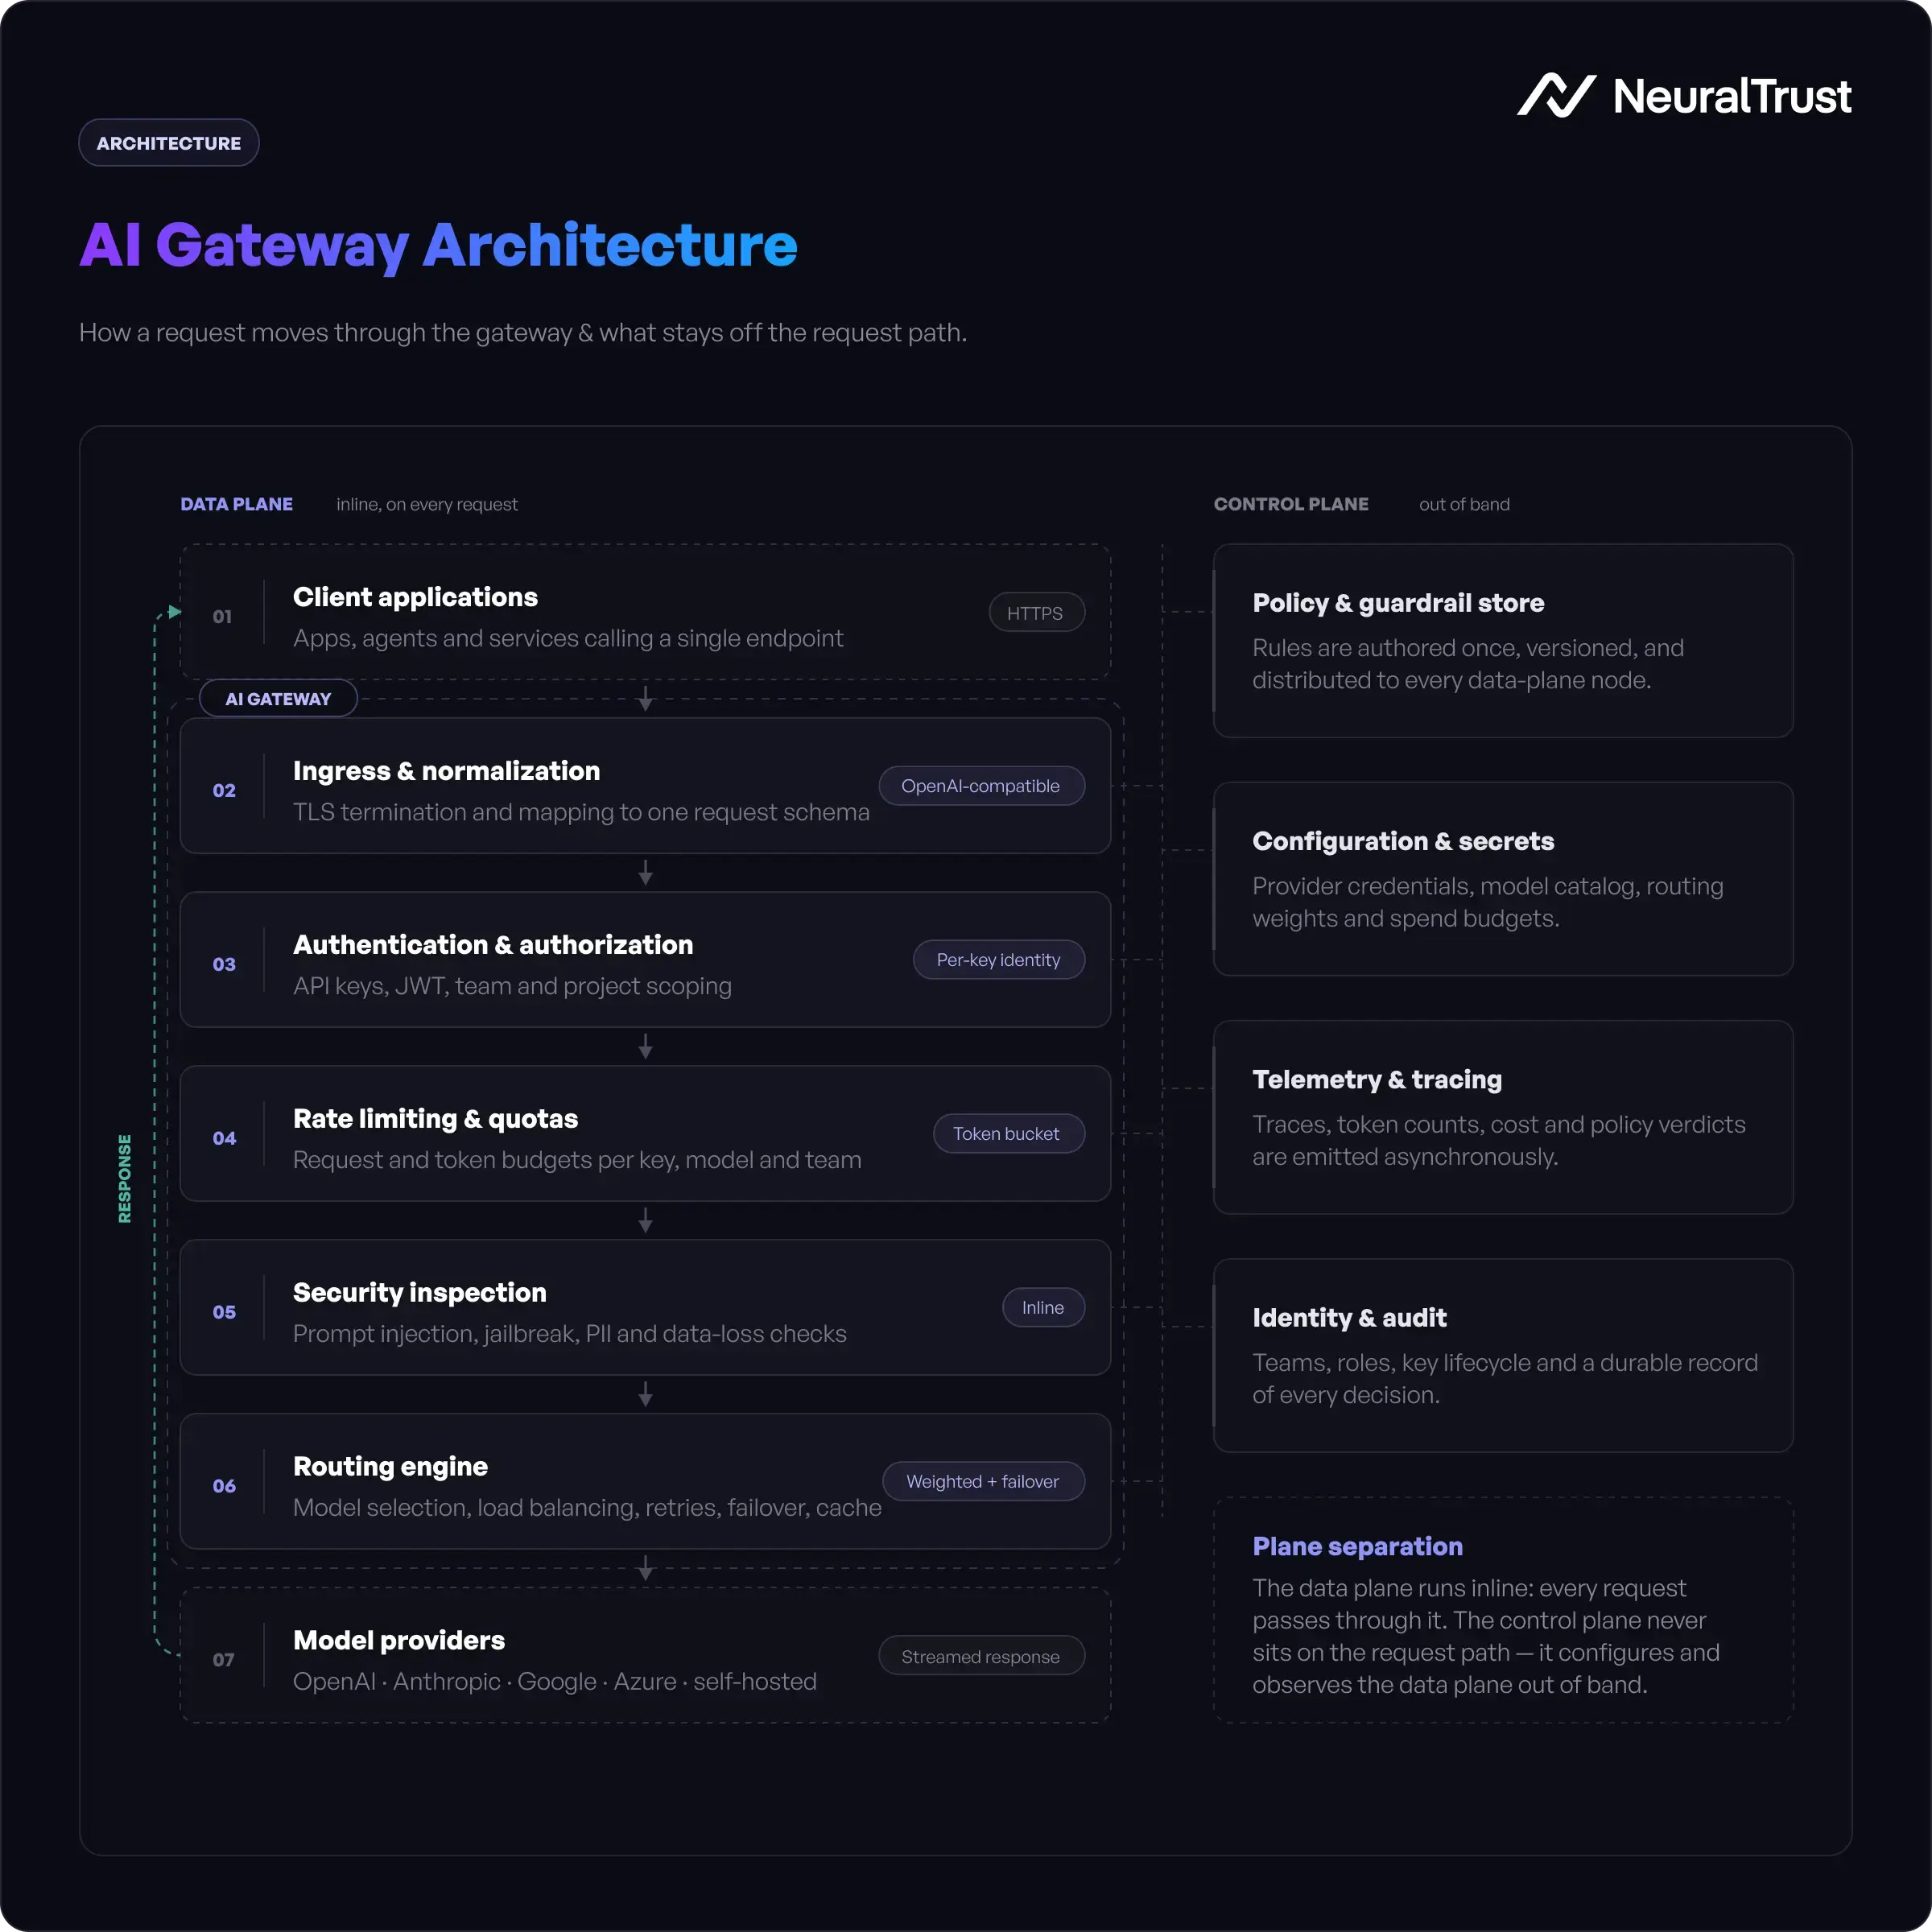
Aquí está el flujo completo. Cinco pasos, una solicitud, milisegundos de principio a fin.
Paso 1: Solicitud recibida
Tu aplicación envía una llamada API al endpoint del gateway. Para la aplicación, esto es idéntico a llamar directamente a un proveedor de LLM. El gateway es transparente en el camino.
Paso 2: Autenticación y control de acceso
¿Quién envió esto? ¿A qué modelos tiene acceso? ¿Qué límites de tasa se aplican? Un token de servicio identifica al solicitante. Si la autenticación falla, la solicitud se detiene aquí. Nada llega al motor de routing.
Paso 3: Decisión de routing
El motor de routing evalúa la solicitud. ¿Qué modelo la gestiona? No es aleatorio. El motor aplica las reglas que tú defines: umbrales de coste, objetivos de latencia, requisitos de capacidad del modelo, disponibilidad actual del proveedor. La decisión ocurre antes de que se realice cualquier llamada upstream.
Paso 4: Inspección de seguridad
Antes de que la solicitud vaya upstream, la capa de seguridad inspecciona el prompt. El prompt injection es la principal amenaza listada en el OWASP LLM Top 10. La capa escanea intentos de inyección, detecta y redacta PII, y aplica tus políticas de contenido. La misma inspección se ejecuta sobre la respuesta antes de devolverla al solicitante. Más sobre la capa de seguridad aquí.
Paso 5: Logging y trazado
Cada interacción se registra: timestamp, identidad del solicitante, modelo utilizado, tokens consumidos, latencia, coste y resultados de políticas. Sin logging no hay depuración, sin atribución de costes y sin evidencia de cumplimiento normativo.
Ciclo completo de ida y vuelta: menos de 100ms en un gateway bien construido.
El Motor de Routing: ¿Cómo Funciona el Routing de LLM?
El motor de routing es la parte técnicamente más interesante. De aquí viene el término "AI router".
Tres estrategias importan en producción.
Balanceo de carga
Distribuye las solicitudes entre múltiples instancias del mismo modelo. Útil cuando estás alcanzando los límites de tasa del proveedor o quieres suavizar la variación de latencia. Patrones estándar de balanceo de carga aplicados a endpoints de LLM: round-robin, ponderado o mínimas conexiones.
Cadenas de fallback
Si tu modelo principal no está disponible o devuelve un error, el gateway reintenta automáticamente con el siguiente proveedor de la cadena. Tú defines el orden. El gateway gestiona el reintento. Tu aplicación recibe una respuesta sin saber que se produjo un fallo. Así es como funciona la observabilidad de LLM real en la práctica: el sistema se recupera y el evento queda registrado.
Routing basado en coste
El motor de routing conoce el coste por token de cada modelo. Tú estableces un umbral: las solicitudes por debajo de una cierta complejidad o estimación de tokens van a modelos más baratos, las que superan el umbral van al más capaz. Esta es una de las palancas más directas para reducir los costes de LLM sin cambiar nada en el código de la aplicación.
Estas tres estrategias juntas significan que no estás atado a un solo proveedor, y no estás pagando de más por tareas simples.
Plano de Control vs Plano de Datos: ¿Por Qué Importa la Separación?
Esta es la decisión arquitectónica con mayores implicaciones de seguridad y cumplimiento normativo.
Un diseño básico ejecuta todo en un solo proceso: gestión de políticas, manejo del tráfico, logging. Simple de construir. Pero significa que el tráfico de LLM tiene que pasar por la infraestructura del proveedor del gateway.
Una arquitectura split-plane separa dos responsabilidades:
- Plano de control: Gestiona la configuración, las políticas y las reglas de routing. Sabe qué aplicar. No toca el tráfico de LLM.
- Plano de datos: Gestiona las solicitudes y respuestas reales de LLM. Se ejecuta en tu infraestructura.
El plano de control le dice al plano de datos qué reglas aplicar. El plano de datos las aplica sin que tu tráfico abandone tu entorno.
Para los sectores regulados, esto no es opcional. El Marco de Gestión de Riesgos de IA del NIST identifica el control de acceso y el manejo de datos como requisitos fundamentales para un despliegue responsable de IA. El Reglamento de IA de la UE, aplicable desde agosto de 2026, exige controles de datos demostrables para los sistemas de IA de alto riesgo. Una arquitectura split-plane es cómo demuestras que esos controles existen. Por qué esto importa para la soberanía de datos.
Comparativa de Patrones Arquitectónicos
Existen tres patrones de despliegue. Tienen propiedades de seguridad genuinamente diferentes.
| Patrón | Ruta de Datos | Latencia | Soberanía | Complejidad |
|---|---|---|---|---|
| Centralizado (SaaS) | Nube del proveedor | Baja | Limitada | Baja |
| Sidecar | Colocado junto a cada app | Muy baja | Alta | Alta |
| Split-plane | Plano de datos en entorno del cliente | Baja | Alta | Media |
El SaaS centralizado es rápido de implementar. Tu tráfico pasa por su nube. Simple operacionalmente, limitado desde el punto de vista de la soberanía de datos.
El sidecar despliega el gateway junto a cada instancia de aplicación. Control máximo, pero complejo de gestionar a escala. Cada nuevo servicio necesita su propio despliegue de gateway.
El split-plane te da soberanía sin la complejidad del sidecar. El plano de datos se ejecuta en tu entorno y se gestiona de forma centralizada a través del plano de control. Ese es el equilibrio adecuado para la mayoría de los despliegues empresariales.
Cómo se comparan los principales AI gateways en estas dimensiones.
La Capa de Plugins y Middleware
Un AI gateway bien diseñado no es monolítico. Es un pipeline.
Cada solicitud pasa por una cadena de plugins, cada uno haciendo una sola tarea:
- Limitador de tasa
- Gestor de autenticación
- Detector de PII
- Escáner de prompt injection
- Router
- Rastreador de costes
- Filtro de respuesta
- Logger de auditoría
Activa lo que necesitas. Desactiva lo que no. El pipeline se ejecuta en orden. Añadir un nuevo paso de inspección significa añadir un plugin, no reconstruir el gateway.
Así es también como los AI gateways y los guardrails trabajan juntos. Un guardrail es un plugin en la cadena de middleware, funcionando junto al routing y el seguimiento de costes como un pipeline coordinado, no como un sistema independiente añadido a posteriori.
Cómo funciona la gestión centralizada de IA a escala.
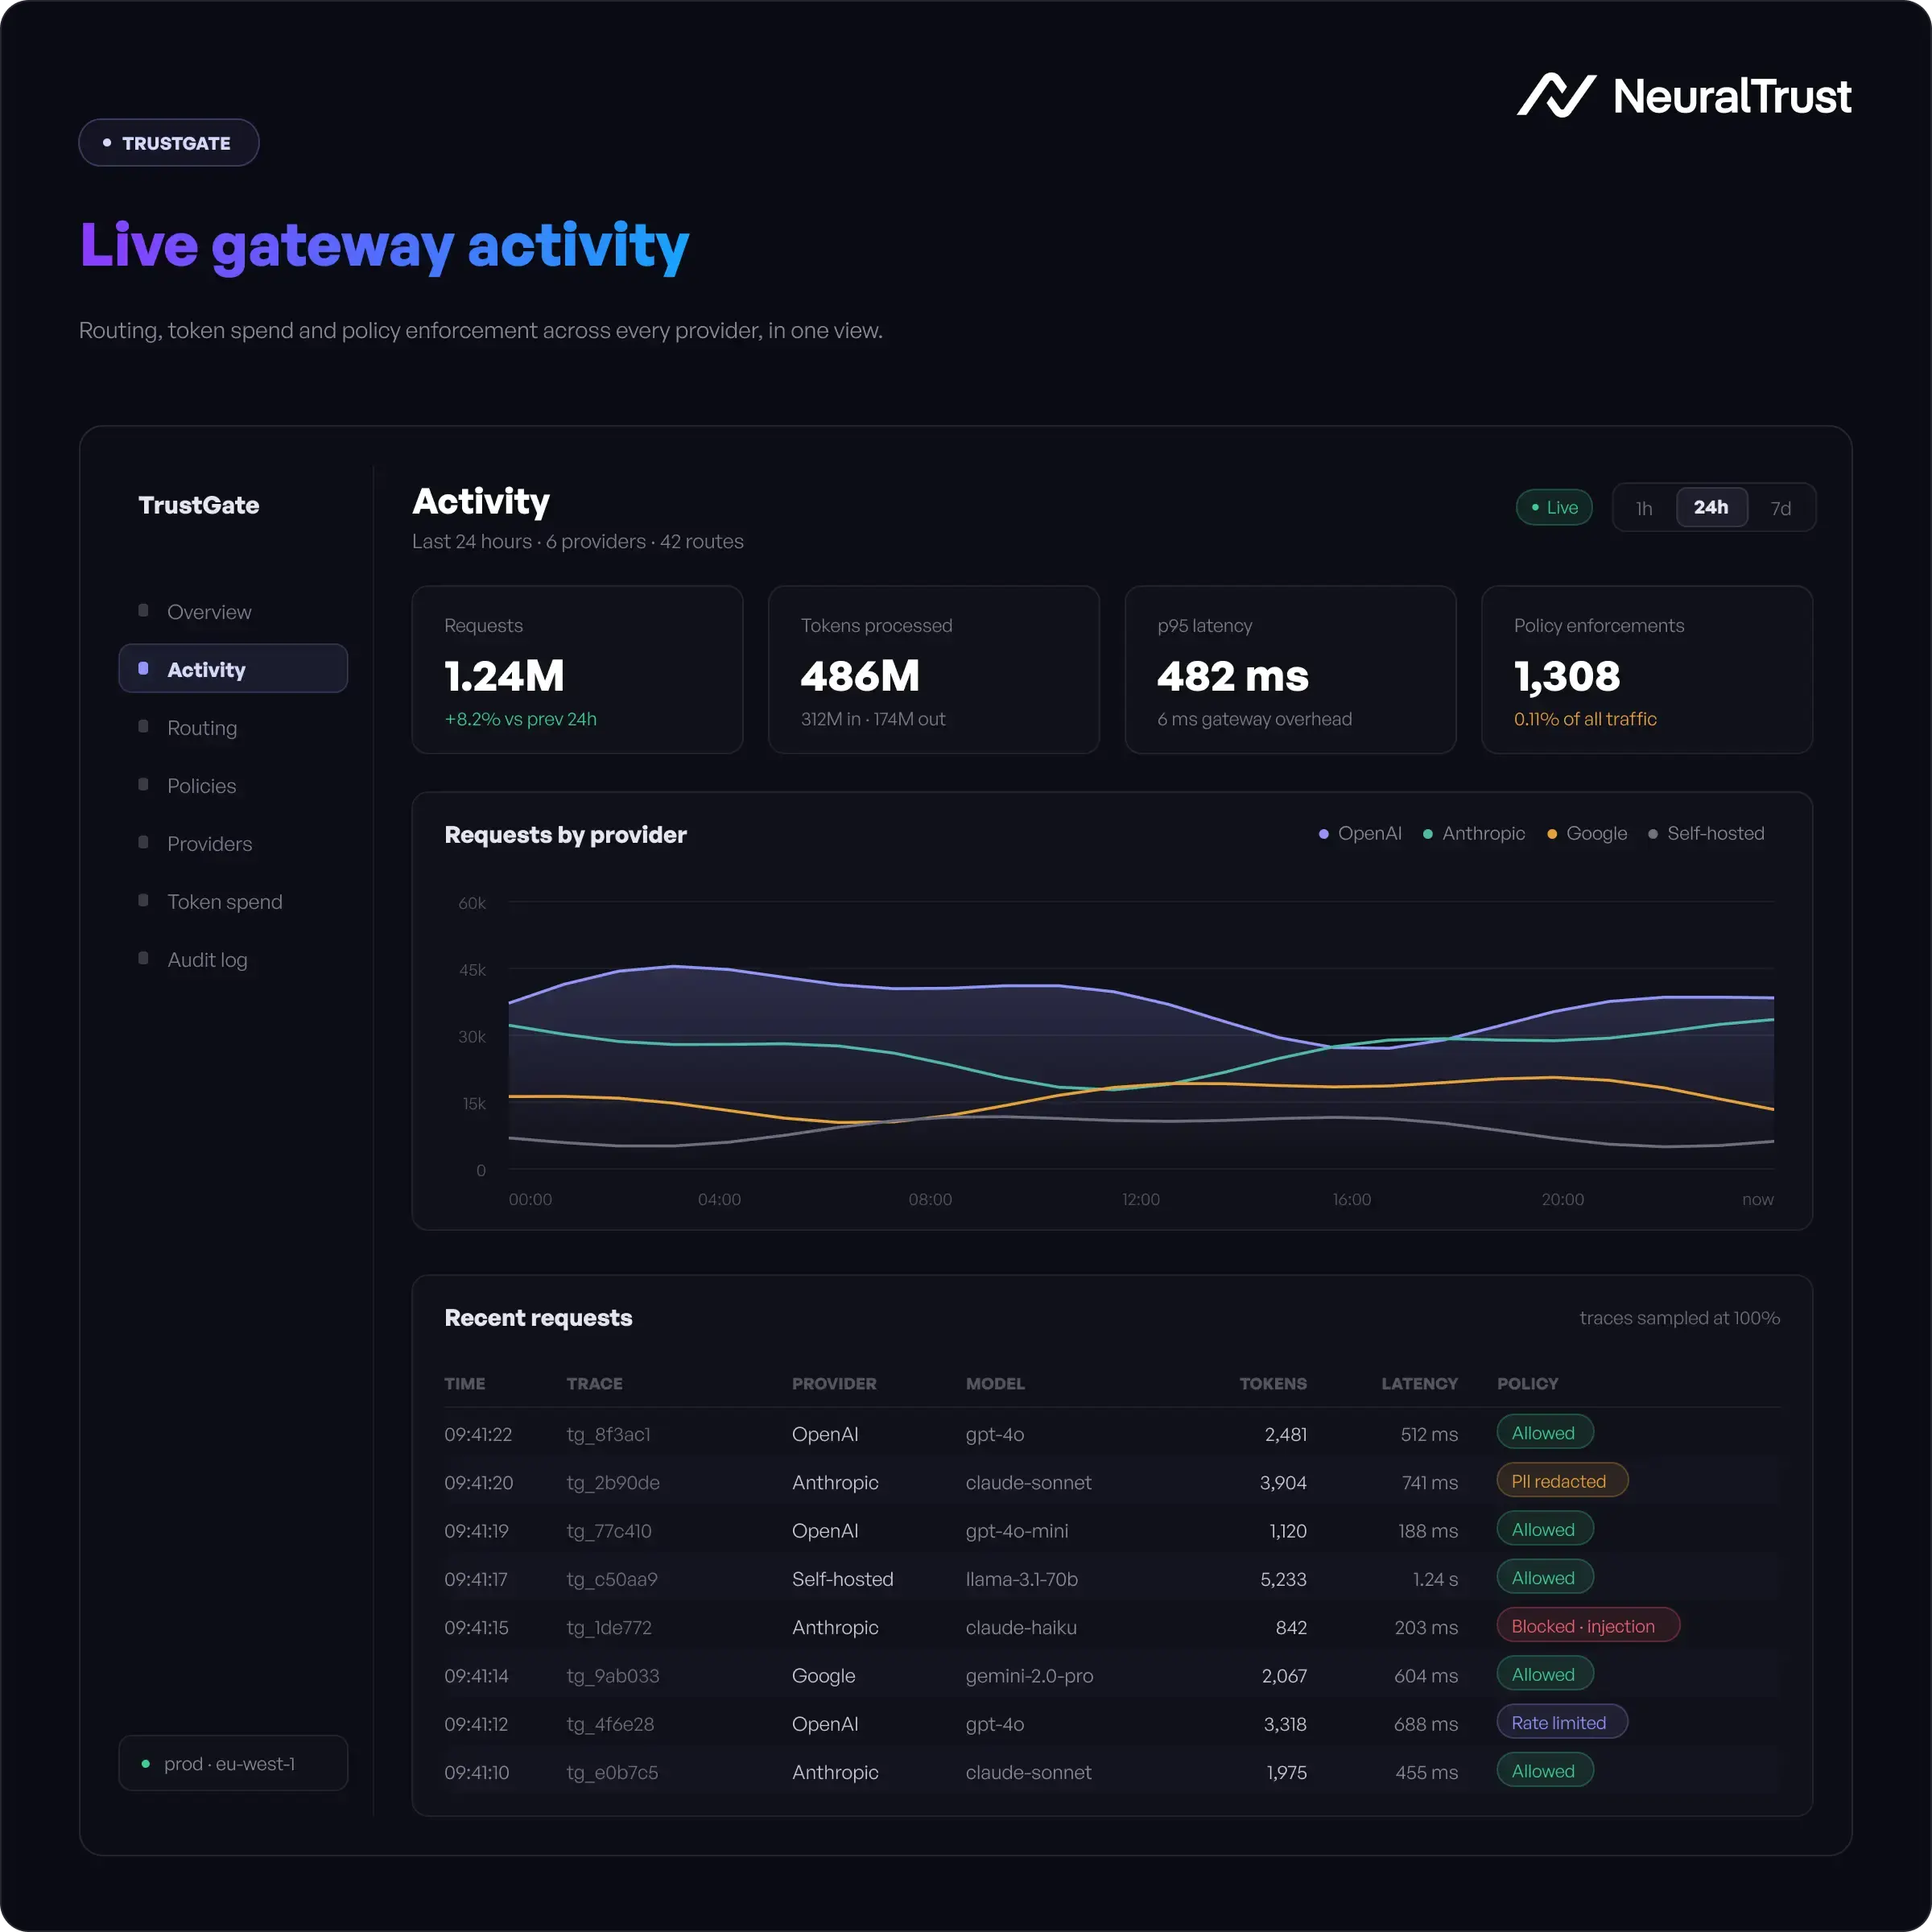
TrustGate: La Arquitectura Split-Plane en la Práctica
TrustGate es el AI gateway de código abierto de NeuralTrust. Implementa el patrón split-plane.
El plano de datos es un servicio de alto rendimiento escrito en Go que se ejecuta en tu clúster de Kubernetes, tu VPC o tu entorno on-premises. Gestiona el routing, la inspección de seguridad y el logging sin que ningún tráfico abandone tu infraestructura.
El plano de control distribuye actualizaciones de políticas al plano de datos. Los cambios de política se propagan en segundos sin tiempo de inactividad.
Latencia inline media: menos de 100ms. Ningún tráfico abandona tu entorno.
Gartner nombró a NeuralTrust Proveedor Representativo en AI Gateways en la Guía de Mercado de Gartner para AI Gateways de 2025.
Ver TrustGate en GitHub | Página de producto TrustGate
La Serie Completa de AI Gateway
- Qué es un AI Gateway: Guía Completa
- AI Gateway vs MCP Gateway
- Seguridad en AI Gateway: Protegiendo el Tráfico de LLM
- Cómo un AI Gateway Resuelve la Observabilidad de LLM
- Cómo un AI Gateway Reduce los Costes de LLM
- AI Gateways vs API Gateways: Las Diferencias
- Gestión Centralizada de IA a Escala
- AI Gateways y Soberanía de Datos
- Mejores AI Gateways en 2026
- AI Gateway vs Guardrails: Lo que Realmente Necesitas
FAQs sobre la arquitectura de AI Gateways
1. ¿Qué es el routing de LLM?
El routing de LLM es el proceso de dirigir cada solicitud de IA al modelo apropiado según las reglas que defines. El motor de routing dentro de un AI gateway evalúa cada solicitud entrante y decide qué modelo la gestiona, en función del coste, los objetivos de latencia, los requisitos de capacidad o la disponibilidad del proveedor. La decisión ocurre en milisegundos, antes de la llamada upstream.
2. ¿Cómo enruta el tráfico un AI gateway?
El motor de routing aplica tres estrategias: balanceo de carga (distribución de solicitudes entre instancias de modelos), cadenas de fallback (reintento automático con modelos alternativos cuando el principal falla) y routing basado en coste (envío de solicitudes más baratas a modelos más económicos). Las reglas se configuran en el plano de control y se aplican en el plano de datos en tiempo de solicitud.
3. ¿Qué es una cadena de fallback en un AI gateway?
Una cadena de fallback es una lista ordenada de proveedores de modelos que el gateway intenta en secuencia cuando el principal falla. Si el primer modelo devuelve un error o está limitado por tasa, el gateway reintenta automáticamente con el siguiente proveedor de la cadena. Tu aplicación recibe una respuesta sin saber que se produjo un fallback.
4. ¿Cuál es la diferencia entre un AI gateway y un LLM proxy?
Un LLM proxy es una capa de reenvío simple: transmite solicitudes a un proveedor de LLM y devuelve respuestas. Un AI gateway hace eso más routing, inspección de seguridad, seguimiento de costes, aplicación de políticas y observabilidad. Un LLM proxy es un componente dentro de la arquitectura de un gateway, no un sustituto del stack completo.
Sobre el Autor
Roger Howroyd es Head of Global SEO and AI en NeuralTrust, donde lidera la estrategia de búsqueda de la empresa en SEO, AEO, GEO y optimización para LLM. Está especializado en búsqueda impulsada por IA, estrategia de contenido y SEM. Conecta en LinkedIn.
NeuralTrust es una plataforma de seguridad para agentes de IA reconocida en el Gartner Hype Cycle for Application Security 2026, la Guía de Mercado de Gartner para AI Gateways y el KuppingerCole Leadership Compass for Generative AI Defense. Certificación ISO 27001. Sede en Barcelona.