¿Cómo se reducen los costes de LLM en producción? Un AI gateway reduce los costes de LLM enrutando cada solicitud al modelo más eficiente en coste capaz de gestionarla, almacenando en caché los prompts repetidos para que las llamadas idénticas nunca lleguen al modelo, aplicando límites de tokens y de velocidad antes de que el gasto se acumule, y atribuyendo cada euro de coste de IA al equipo o aplicación que lo generó. Sin un gateway, el gasto en LLM crece sin control hasta aparecer como una sorpresa en la factura de la nube.
TL;DR - Puntos clave
- Los costes de LLM son costes de infraestructura: necesitan los mismos controles centralizados que el cómputo y el almacenamiento, lo que significa una capa de gateway, no registros por aplicación
- El enrutamiento inteligente dirige las solicitudes simples a modelos más baratos y las complejas a modelos más capaces, reduciendo costes sin modificar el código de la aplicación
- La caché semántica elimina llamadas redundantes al modelo por completo: si dos usuarios hacen la misma pregunta, solo la primera llamada llega al modelo
- Los presupuestos de tokens y los límites de velocidad limitan el gasto por usuario, por agente y por aplicación antes de que se acumule
- La atribución de costes por equipo o aplicación es el requisito previo para cualquier reducción significativa de costes, no se puede recortar lo que no se puede ver
- Según Andreessen Horowitz, los costes de inferencia de IA representan la partida individual más grande en la pila de aplicaciones de IA para la mayoría de las empresas que escalan más allá del prototipo
- TrustGate, el AI gateway open-source de NeuralTrust, implementa todos estos mecanismos en la capa de infraestructura sin necesidad de cambios a nivel de aplicación
La factura de LLM que nadie vio venir
Lanzaste la funcionalidad de IA. A los usuarios les encanta. Luego llega la factura.
Este es el patrón. Los equipos desarrollan funcionalidades basadas en LLM rápidamente, se centran en la calidad y la latencia, y tratan el coste como un problema a resolver más adelante. Más adelante llega a escala, y los números son difíciles de explicar a un director financiero porque nadie puede decirle qué equipo, qué funcionalidad o qué prompt está generando el gasto.
El problema es estructural. La mayoría de los equipos instrumentan los costes de LLM a nivel de aplicación: una app, una clave de API, una línea de facturación. En cuanto tienes múltiples aplicaciones, múltiples modelos o múltiples equipos compartiendo infraestructura de IA, la instrumentación por aplicación deja de ofrecer una imagen útil. Ves el gasto total, pero no de dónde viene ni qué recortar.
Un AI gateway resuelve esto moviendo el control de costes a la única capa que lo ve todo: la capa de infraestructura entre tus aplicaciones y tus proveedores de modelos.
¿Por qué los costes de LLM se disparan sin un gateway?
Antes de analizar las soluciones, conviene ser preciso sobre qué impulsa el gasto en LLM fuera de control, porque las causas determinan qué controles funcionan realmente.
1. Solicitudes sin enrutar. Cada solicitud va al mismo modelo independientemente de su complejidad. Una respuesta simple a una FAQ cuesta lo mismo que una tarea de razonamiento en varios pasos porque nada en la pila distingue entre ellas.
2. Llamadas redundantes. Los mismos prompts, o prompts semánticamente idénticos, llegan al modelo repetidamente. Una herramienta de atención al cliente que responde "¿cuál es tu política de devoluciones?" cincuenta veces al día realiza cincuenta llamadas al modelo cuando una respuesta en caché sería suficiente.
3. Sin límites por usuario o por agente. Un único agente que funciona mal, un bucle de reintentos roto o un usuario con sesiones inusualmente largas pueden generar miles de tokens sin ningún cortocircuito.
4. Sin atribución. Sin saber qué equipo o aplicación generó qué gasto, las conversaciones sobre reducción de costes son conjeturas. Puedes reducir la factura total, pero no identificar la causa específica.
5. Pagar de más por la capacidad del modelo. La mayoría de las cargas de trabajo de IA en producción son una combinación de tareas simples y complejas, pero sin lógica de enrutamiento, todas pagan el precio del modelo más capaz (y caro) de la pila.
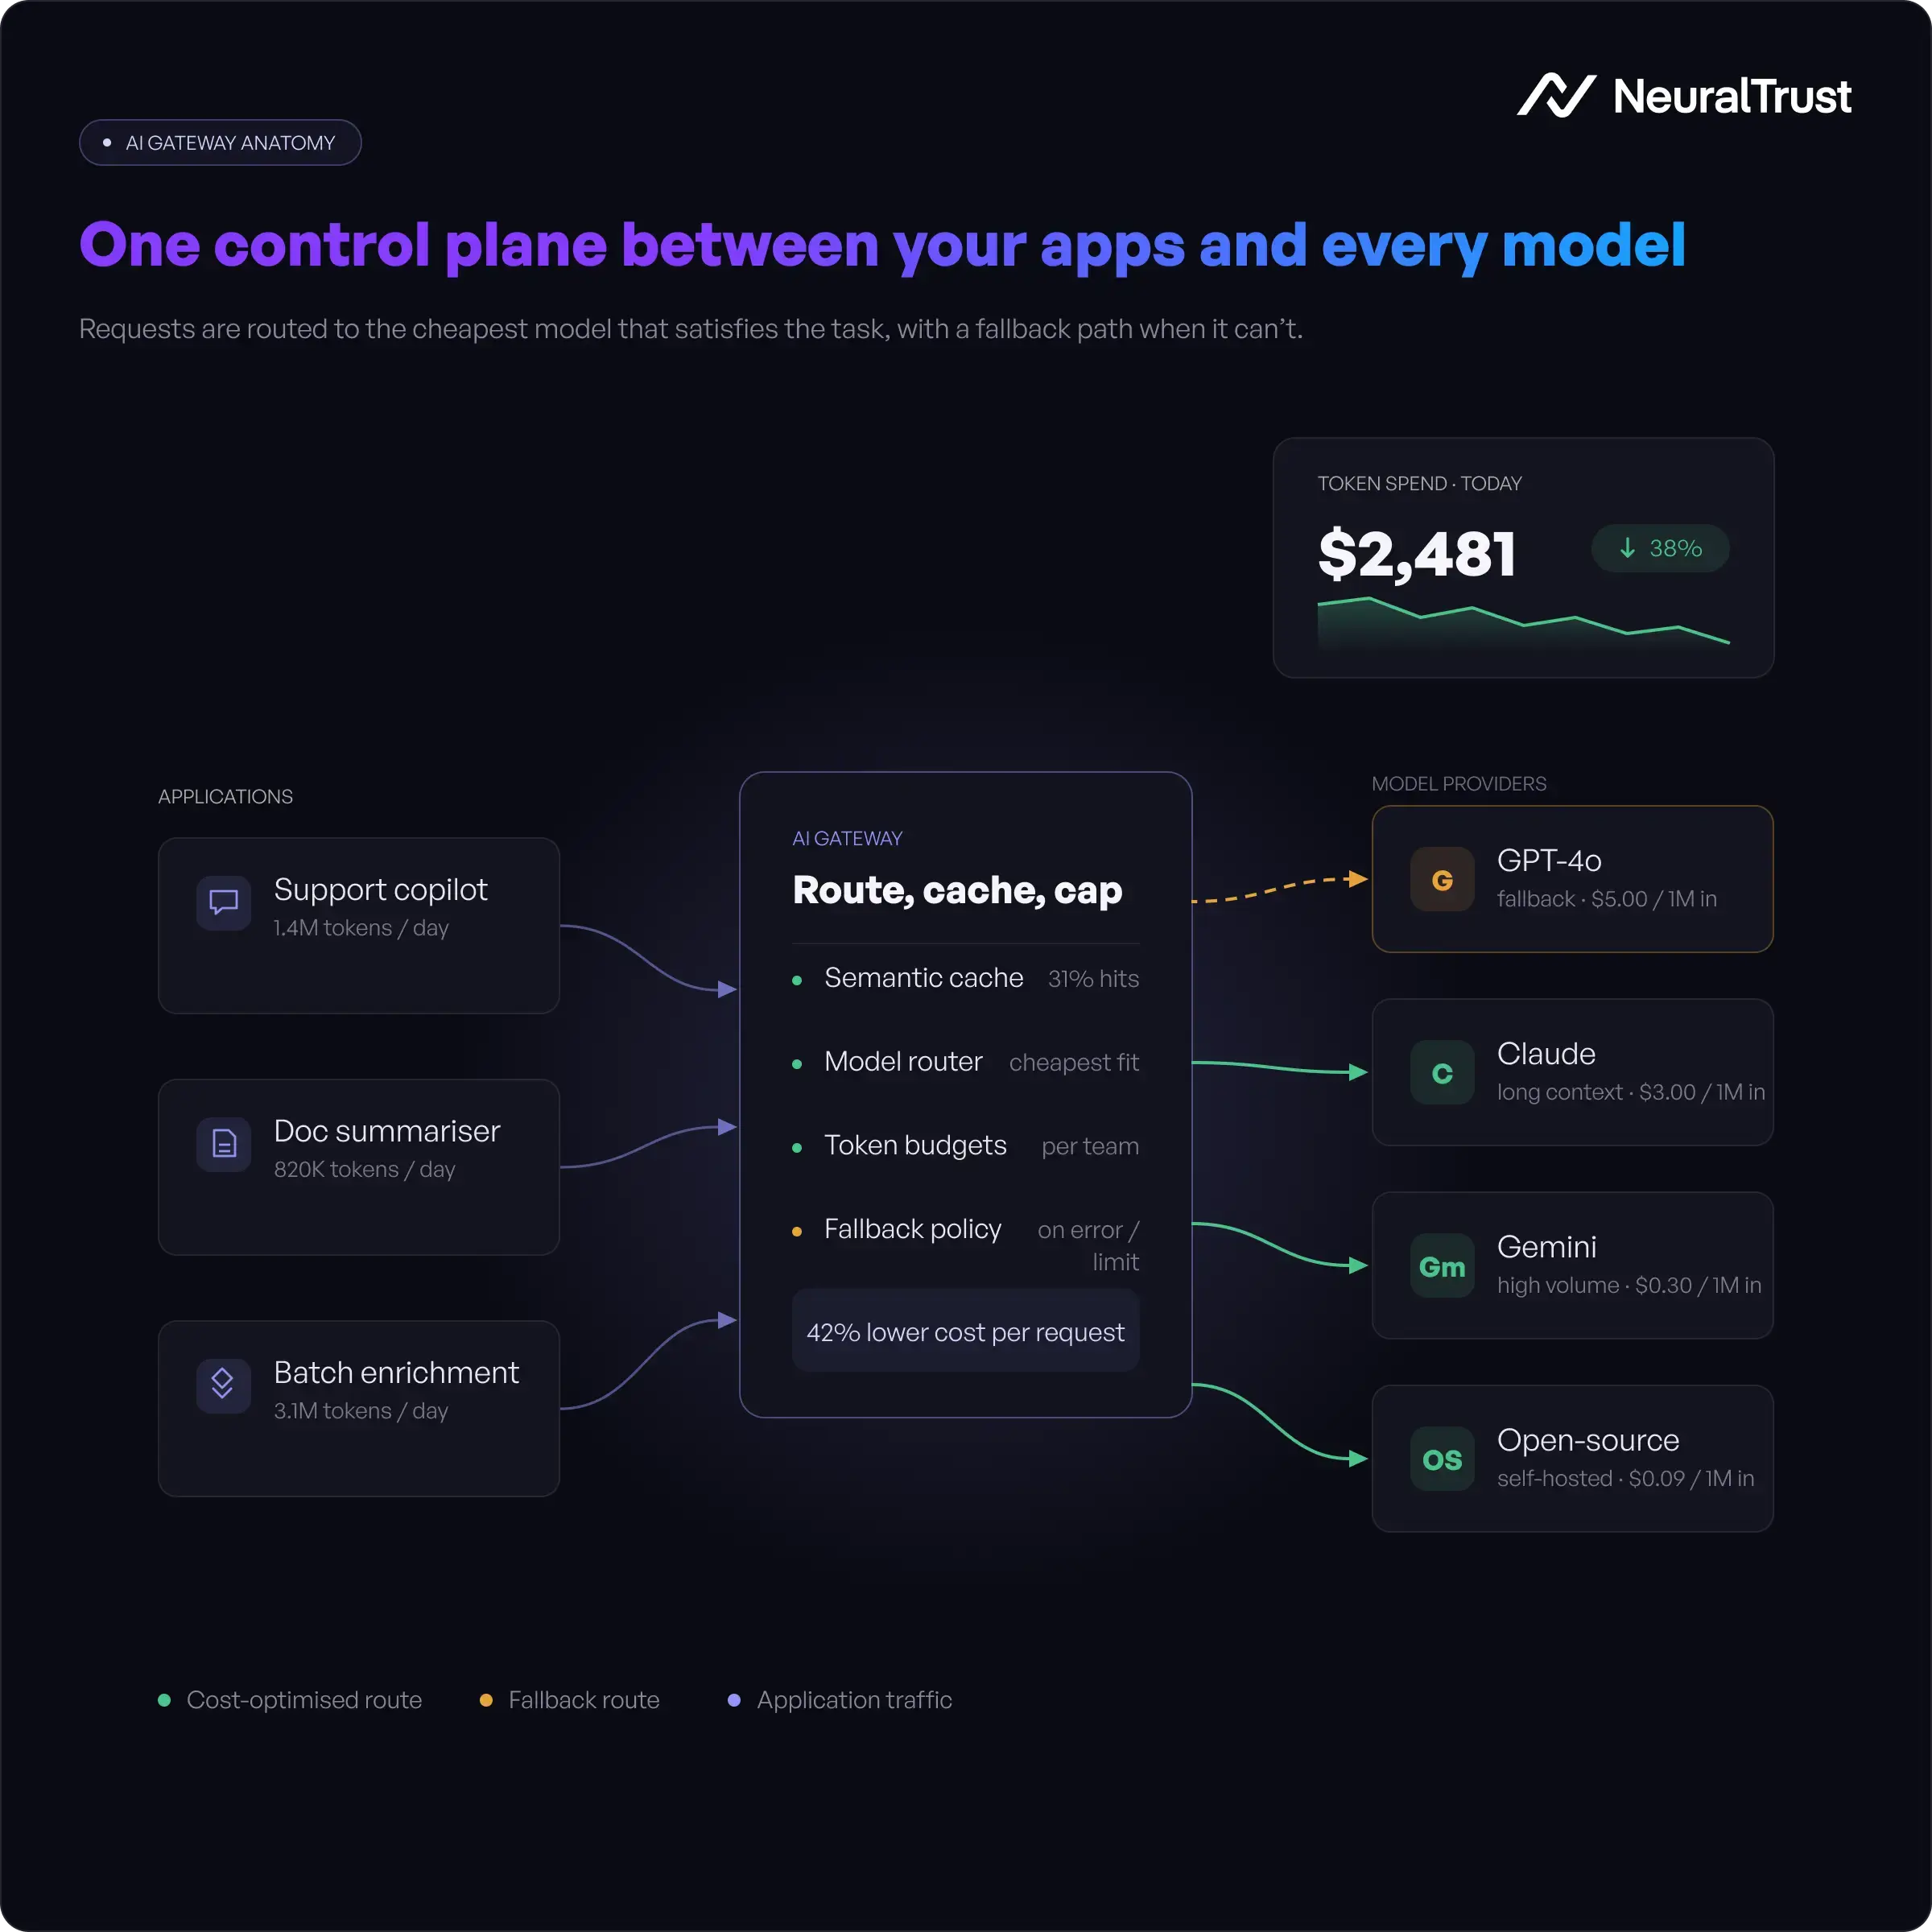
Un AI gateway aborda los cinco. No cambiando tus aplicaciones, sino añadiendo una capa de control por la que tus aplicaciones ya enrutan.
¿Cómo un AI gateway reduce los costes de LLM?: los cinco mecanismos
1. Enrutamiento inteligente (selección de modelo basada en coste)
El motor de enrutamiento dentro de un AI gateway evalúa cada solicitud entrante y la dirige al modelo más eficiente en coste capaz de gestionarla. Tú defines las reglas: las solicitudes por debajo de cierta complejidad o estimación de tokens van a modelos más baratos; las que superan ese umbral van a modelos más capaces.
En la práctica, esto se parece a una pila de modelos por niveles:
| Tipo de solicitud | Enrutada a | Ahorro típico de coste |
|---|---|---|
| FAQ simple, clasificación, resumen breve | Modelo pequeño o de nivel medio | 70-90% por llamada vs modelo frontier |
| Generación de código, razonamiento en varios pasos | Modelo frontier | Línea base |
| Consulta repetida o en caché | Caché (sin llamada al modelo) | 100% |
La decisión de enrutamiento ocurre en milisegundos antes de la llamada al proveedor. Tu aplicación envía una solicitud estándar al gateway; el gateway decide qué modelo la gestiona. Sin cambios en la aplicación.
Este es uno de los recursos más directos disponibles. Según la investigación sobre enrutamiento de LLM de Martian, los equipos que utilizan enrutamiento basado en costes reducen típicamente el gasto en inferencia entre un 40-70% sin degradación measurable en la calidad del output para la mayoría de su carga de trabajo.
2. Caché semántica
La caché semántica va más allá de la caché de coincidencia exacta. En lugar de devolver únicamente una respuesta en caché cuando el prompt es carácter por carácter idéntico, una caché semántica utiliza similitud de embeddings para identificar prompts que preguntan lo mismo con palabras distintas.
"¿Cuál es tu política de devoluciones?" y "¿Cómo devuelvo un artículo?" son cadenas diferentes pero semánticamente equivalentes. Una caché semántica captura ambas y devuelve la misma respuesta en caché sin tocar el modelo.
Para aplicaciones de producción de alto volumen, son habituales tasas de solicitudes en caché del 20-40%. Cada solicitud en caché no cuesta nada. A escala, eso es una parte significativa de la factura del modelo eliminada por completo.
El gateway gestiona la búsqueda en caché, las escrituras en caché y la invalidación de caché. Las aplicaciones reciben respuestas con la misma latencia que una llamada al modelo (o más rápido), sin visibilidad sobre si la respuesta vino de la caché o del modelo.
3. Presupuestos de tokens y limitación de velocidad
La limitación de velocidad basada en tokens es fundamentalmente diferente de la limitación basada en recuento de solicitudes, y es la abstracción correcta para el control de costes de LLM.
Un único prompt largo con una finalización larga puede costar 100 veces más que uno corto. Los límites de recuento de solicitudes no capturan esto. Los presupuestos de tokens sí.
Un AI gateway aplica presupuestos de tokens en múltiples niveles:
- Por solicitud: Tokens máximos de entrada y salida por llamada
- Por usuario: Asignación diaria u horaria de tokens antes de que entre en vigor la limitación
- Por aplicación: Cuota mensual de tokens que activa alertas o límites de velocidad cuando se aproxima
- Por agente: Límites estrictos sobre cuántos tokens puede consumir un agente autónomo en una sesión
Este es el cortocircuito para el gasto desbocado. Un bucle de agente roto que de otro modo realizaría 10.000 llamadas a la API alcanza el presupuesto de tokens y se detiene. El radio de explosión queda limitado antes de llegar a la factura.
La limitación de velocidad también protege contra ataques de inyección de prompts diseñados para extraer finalizaciones largas o activar cadenas de herramientas costosas, lo que conecta directamente con la capa de seguridad que aplica tu AI gateway.
4. Cadenas de fallback (evitar la lógica de reintentos costosa)
Sin un gateway, la lógica de reintentos a nivel de aplicación suele reintentar con el mismo proveedor (a coste completo) cuando una solicitud falla. Un gateway implementa cadenas de fallback inteligentes: cuando el modelo principal no está disponible o ha alcanzado su límite de velocidad, la solicitud se enruta automáticamente al siguiente proveedor de la cadena.
Esto tiene dos beneficios en costes. Primero, evita el coste de latencia de las solicitudes fallidas que luego se reintentan manualmente. Segundo, puedes configurar la cadena de fallback para enrutar a modelos más baratos cuando el principal está degradado, de modo que el tiempo de inactividad no fuerce una intervención manual costosa.
Tú defines la cadena. El gateway gestiona el reintento. Las aplicaciones reciben una respuesta sin saber que se produjo un fallback. Más sobre cómo funcionan las cadenas de fallback en el motor de enrutamiento.
5. Atribución de costes por equipo y aplicación
La atribución de costes no es en sí misma un mecanismo de reducción de costes. Es el requisito previo para que todos los demás mecanismos funcionen.
Sin saber qué equipo gasta qué, no puedes tener una conversación de reducción de costes con los responsables de ingeniería. No puedes establecer presupuestos de tokens significativos. No puedes identificar qué aplicación es el mayor generador de costes. No puedes mostrar al director financiero un plan creíble.
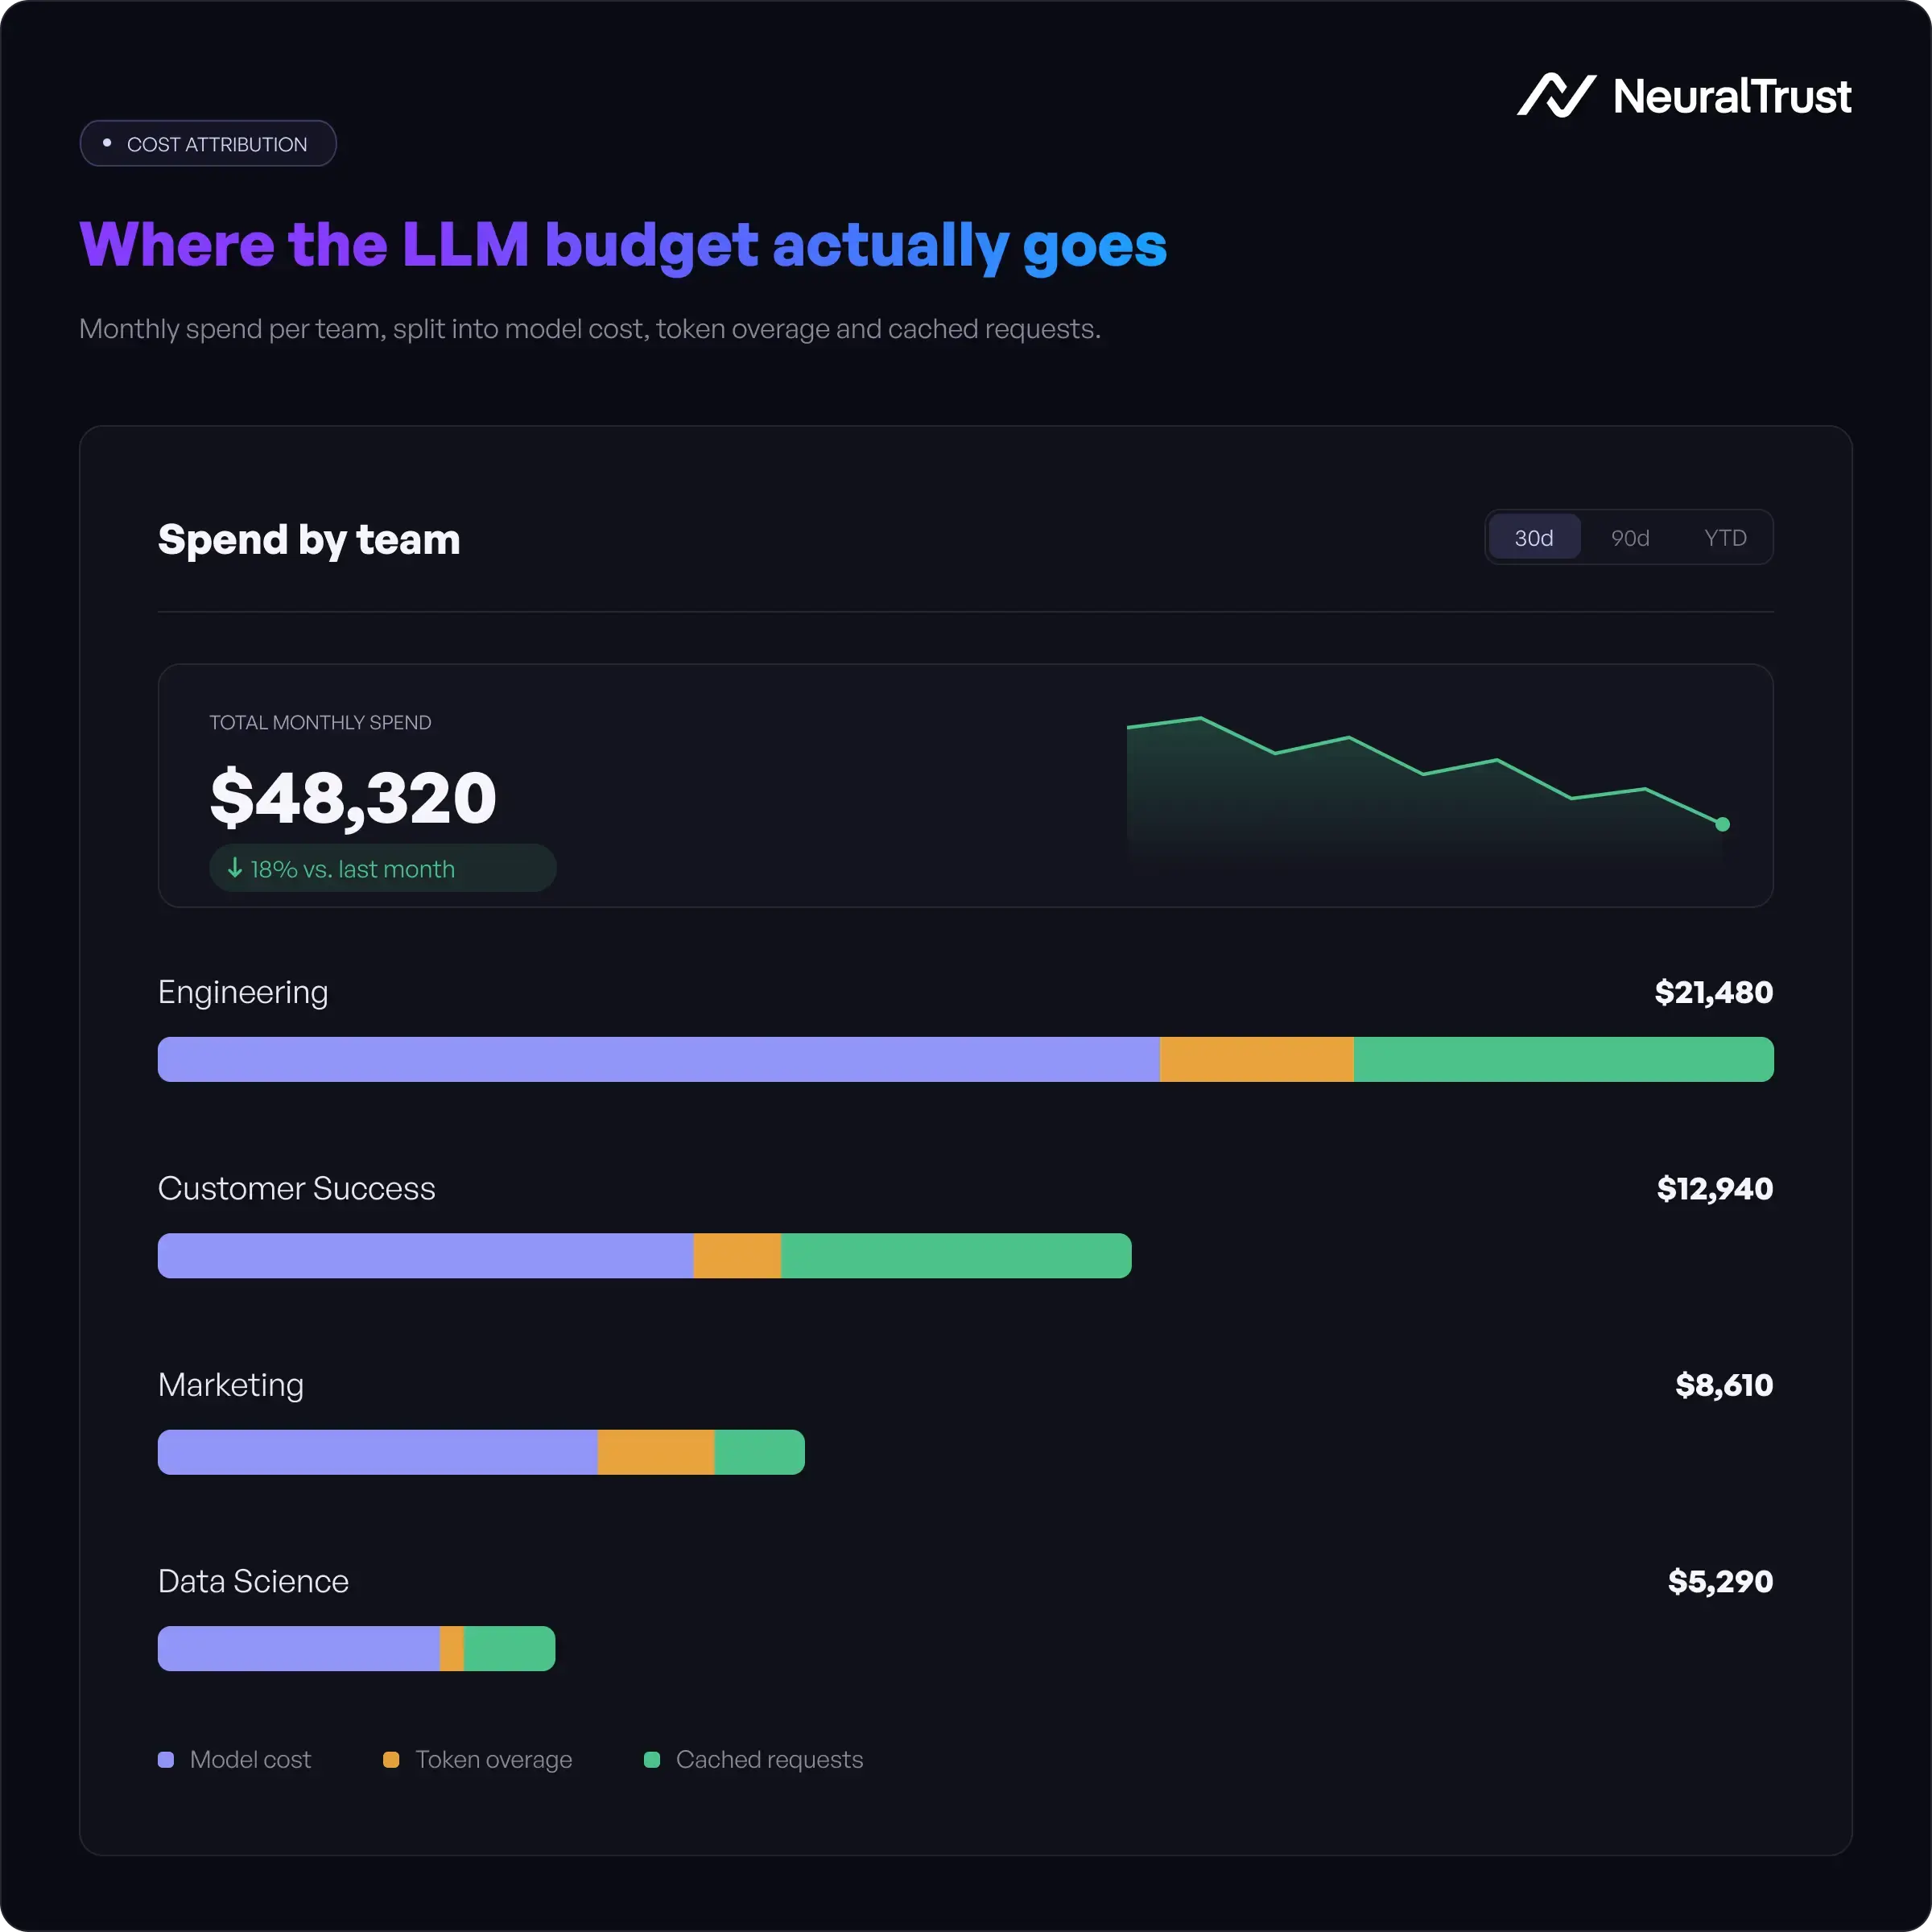
Un gateway etiqueta cada solicitud con su origen (clave de API, identidad del servicio, etiqueta del equipo o nombre de la aplicación) y lo agrega en informes de costes: gasto por equipo al día, gasto por modelo a la semana, coste por tipo de solicitud. Esta es la capa de observabilidad que hace operativa la gestión de costes de LLM.
Una vez establecida la atribución, el patrón de reducción de costes es sencillo: identificar el equipo o aplicación con mayor gasto, ver qué modelo utilizan y si el enrutamiento podría trasladar parte de su carga de trabajo a modelos más baratos, comprobar su tasa de aciertos en caché y revisar si el uso de tokens por solicitud está dentro de los rangos esperados.
¿Cómo se ve la optimización de costes de LLM en la práctica?
Este es un ejemplo realista de cómo se ve un equipo de ingeniería de tamaño mediano antes y después de desplegar un AI gateway con controles de costes.
| Métrica | Antes del gateway | Después del gateway | Cambio |
|---|---|---|---|
| Coste medio por solicitud | $0,042 | $0,016 | -62% |
| Tasa de aciertos en caché | 0% | 31% | +31pp |
| Solicitudes enrutadas a modelos más baratos | 0% | 58% | +58pp |
| Incidentes de agente desbocado por mes | 4 | 0 | -100% |
| Cobertura de atribución de costes | 0% | 100% | Visibilidad completa |
| Tiempo para identificar anomalías de coste | Días | Minutos | Alertas en tiempo real |
La reducción de costes proviene de tres lugares simultáneamente: enrutamiento, caché y eliminación del gasto desbocado. La atribución hace que todo sea visible y auditable.
La capa MCP: control de costes para llamadas de herramientas de agentes
A medida que los agentes de IA son más habituales en producción, los costes de LLM ya no son solo de inferencia de modelos. Los agentes realizan llamadas de herramientas, recuperan contexto y encadenan múltiples invocaciones de modelos para completar una tarea. Cada paso suma a la factura.
El Model Context Protocol (MCP) es el estándar que rige cómo los agentes se conectan a herramientas y fuentes de datos. Un AI gateway que opera en la capa MCP puede aplicar controles de coste directamente a las llamadas de herramientas de los agentes: limitando cuántas llamadas puede realizar un agente por sesión, a qué fuentes de datos puede acceder y cuánto contexto puede extraer antes de que los costes se acumulen.
Sin controles en la capa MCP, un agente que debería responder a un ticket de soporte puede realizar docenas de llamadas de herramientas e invocaciones de modelos antes de devolver una respuesta, a múltiplos del coste esperado. Con controles a nivel de gateway tanto en la capa de LLM como en la capa MCP, ese comportamiento está acotado.
TrustGate: optimización de costes en la capa de infraestructura
TrustGate es el AI gateway open-source de NeuralTrust. Implementa los cinco mecanismos de coste descritos anteriormente en la capa de infraestructura, aplicándose a cada aplicación y cada modelo de tu pila desde un único despliegue.
- El enrutamiento inteligente se configura de forma declarativa: define umbrales de coste, niveles de modelos y reglas de enrutamiento una vez. El gateway las aplica en cada solicitud.
- La caché semántica está integrada en el plano de datos. Los aciertos en caché se registran junto a los errores de caché para que puedas medir los ahorros directamente.
- Los presupuestos de tokens y los límites de velocidad se establecen por clave de API, por usuario o por aplicación y se aplican en tiempo real.
- Las cadenas de fallback enrutan automáticamente a proveedores alternativos o modelos más baratos cuando el principal está degradado.
- La atribución de costes se captura en cada solicitud y se muestra en el dashboard de observabilidad, desglosada por equipo, aplicación, modelo y período de tiempo.
TrustGate se ejecuta en tu propia infraestructura (Kubernetes, VPC o on-premises) para que el tráfico de LLM nunca abandone tu entorno. El plano de control gestiona la política sin tocar tus datos.
Ver TrustGate en GitHub | Página de producto TrustGate
Empieza a reducir tus costes de LLM hoy
Sin llamada de ventas. Sin tarjeta de crédito. Despliega TrustGate en tu propio entorno y obtén visibilidad completa de tu gasto en LLM (con enrutamiento, caché y limitación de velocidad activos) en minutos.
FAQs sobre la reducción de costes de LLM con un AI gateway
1. ¿Cómo reduce un AI gateway los costes de LLM?
Un AI gateway reduce los costes de LLM mediante cinco mecanismos: enrutamiento inteligente (dirigiendo las solicitudes al modelo más barato capaz de gestionarlas), caché semántica (devolviendo respuestas en caché para consultas repetidas o similares sin tocar el modelo), presupuestos de tokens y límites de velocidad (limitando el gasto por usuario y por aplicación antes de que se acumule), cadenas de fallback (evitando reintentos manuales costosos cuando los proveedores se degradan) y atribución de costes (haciendo visible cada euro de gasto en IA por equipo y aplicación).
2. ¿Qué es el enrutamiento de LLM basado en coste?
El enrutamiento de LLM basado en coste es la práctica de dirigir cada solicitud de IA al modelo más eficiente en coste capaz de gestionarla, en lugar de enviar todas las solicitudes al mismo modelo independientemente de su complejidad. Un motor de enrutamiento evalúa cada solicitud según reglas que tú defines (estimaciones de complejidad, recuentos de tokens, tipo de tarea) y selecciona el nivel de modelo apropiado. Las tareas simples van a modelos más baratos; las complejas van a modelos frontier. La decisión ocurre en la capa del gateway antes de que se realice cualquier llamada al proveedor.
3. ¿Qué es la caché semántica en un AI gateway?
La caché semántica es un mecanismo de caché que devuelve respuestas almacenadas para prompts que son semánticamente equivalentes, no solo carácter por carácter idénticos. Utiliza similitud de embeddings para comparar los prompts entrantes con los ya respondidos. Esto captura versiones parafraseadas de la misma pregunta y elimina llamadas redundantes al modelo. Para aplicaciones de producción de alto volumen, son habituales tasas de aciertos en caché semántica del 20-40%, reduciendo el volumen de llamadas al modelo (y el coste) en consecuencia.
4. ¿Cómo funcionan los presupuestos de tokens en un AI gateway?
Los presupuestos de tokens establecen un número máximo de tokens de entrada y salida que un usuario, aplicación o agente puede consumir en un período determinado. El gateway aplica el presupuesto en tiempo real, limitando o bloqueando las solicitudes que lo superarían. Este es el mecanismo principal para contener el gasto desbocado provocado por bucles de agentes rotos, sesiones inusualmente largas o ataques de inyección de prompts diseñados para activar finalizaciones costosas. A diferencia de los límites de recuento de solicitudes, los presupuestos de tokens reflejan el factor de coste real en la infraestructura de LLM.
5. ¿Puede un AI gateway reducir costes sin cambiar el código de la aplicación?
Sí. Dado que un AI gateway se sitúa entre tus aplicaciones y tus proveedores de LLM, aplica enrutamiento, caché y limitación de velocidad en la capa de infraestructura. Las aplicaciones envían solicitudes al endpoint del gateway exactamente igual que las enviarían directamente a un proveedor. El gateway gestiona todas las decisiones de control de costes de forma transparente. Sin cambios en el SDK, sin refactorización de la aplicación y sin instrumentación por servicio requerida.
6. ¿Cuál es la relación entre la optimización de costes de LLM y la observabilidad de LLM?
La optimización de costes depende de la observabilidad. No puedes enrutar de forma inteligente sin saber qué solicitudes son más caras. No puedes establecer presupuestos de tokens significativos sin conocer los patrones de uso actuales. No puedes identificar anomalías de coste sin monitorización en tiempo real. La atribución de costes (saber qué equipo o aplicación generó qué gasto) es el requisito previo para toda reducción de costes específica. Un AI gateway proporciona ambas simultáneamente: los datos de observabilidad que identifican el problema y los mecanismos de control que lo resuelven.
Artículos relacionados
- Qué es un AI Gateway: Guía Completa
- AI Gateway vs MCP Gateway
- Seguridad del AI Gateway: Protegiendo el tráfico de LLM
- Arquitectura del AI Gateway: Cómo funciona por dentro
- Observabilidad de LLM con un AI Gateway
- Optimización de Tokens de IA: Guía Completa para Reducir los Costes de LLM
Sobre el autor
Roger Howroyd es Head of Global SEO and AI en NeuralTrust, donde lidera la estrategia de búsqueda de la empresa en SEO, AEO, GEO y optimización para LLM. Está especializado en búsqueda impulsada por IA, estrategia de contenido y SEM. Conéctate en LinkedIn.
NeuralTrust es una plataforma de seguridad para agentes de IA reconocida en el Gartner Hype Cycle for Application Security 2026, la Gartner Market Guide for AI Gateways y el KuppingerCole Leadership Compass for Generative AI Defense. Certificada ISO 27001. Sede en Barcelona.