Última actualización: octubre de 2026
En abril de 2026, el chatbot de atención al cliente de McDonald's respondió a preguntas técnicas de programación sin ninguna relación con menús, pedidos o tiendas. El fallo tiene nombre: fuga de capacidades. Y McDonald's no es la única marca afectada.
TL;DR - Puntos Clave
- McDonald's desplegó un LLM de propósito general para atención al cliente; los usuarios lo dirigieron a realizar tareas de codificación fuera de su ámbito previsto, un fallo conocido como fuga de capacidades. (DEV Community, 2026)
- La misma vulnerabilidad afectó a Alcampo y Chipotle en 2026, confirmando que se trata de un riesgo sistémico del sector, no de un incidente aislado.
- La inyección de prompts ocupa el puesto número 1 en el OWASP Top 10 para aplicaciones LLM 2026, la amenaza de seguridad en IA más frecuente en sistemas en producción. (OWASP, 2026)
- Gartner predice que el 25% de las aplicaciones de IA generativa empresarial experimentarán al menos cinco incidentes de seguridad menores por año antes de 2028. (Gartner, abril de 2026)
- Las restricciones del system prompt no pueden eliminar las capacidades subyacentes del modelo. Los controles arquitectónicos, el filtrado a nivel de gateway y el red teaming previo al despliegue son las contramedidas eficaces.
- El incidente de McDonald's fue desencadenado por prompts de usuario estándar, no por ataques sofisticados. Este es el escenario adversarial base que toda IA orientada al consumidor debe superar.
El incidente del chatbot de McDonald's: qué ocurrió exactamente
En abril de 2026, McDonald's se convirtió en la última gran marca en comprobar que desplegar un chatbot de IA para atención al cliente no equivale a desplegar una IA de atención al cliente.
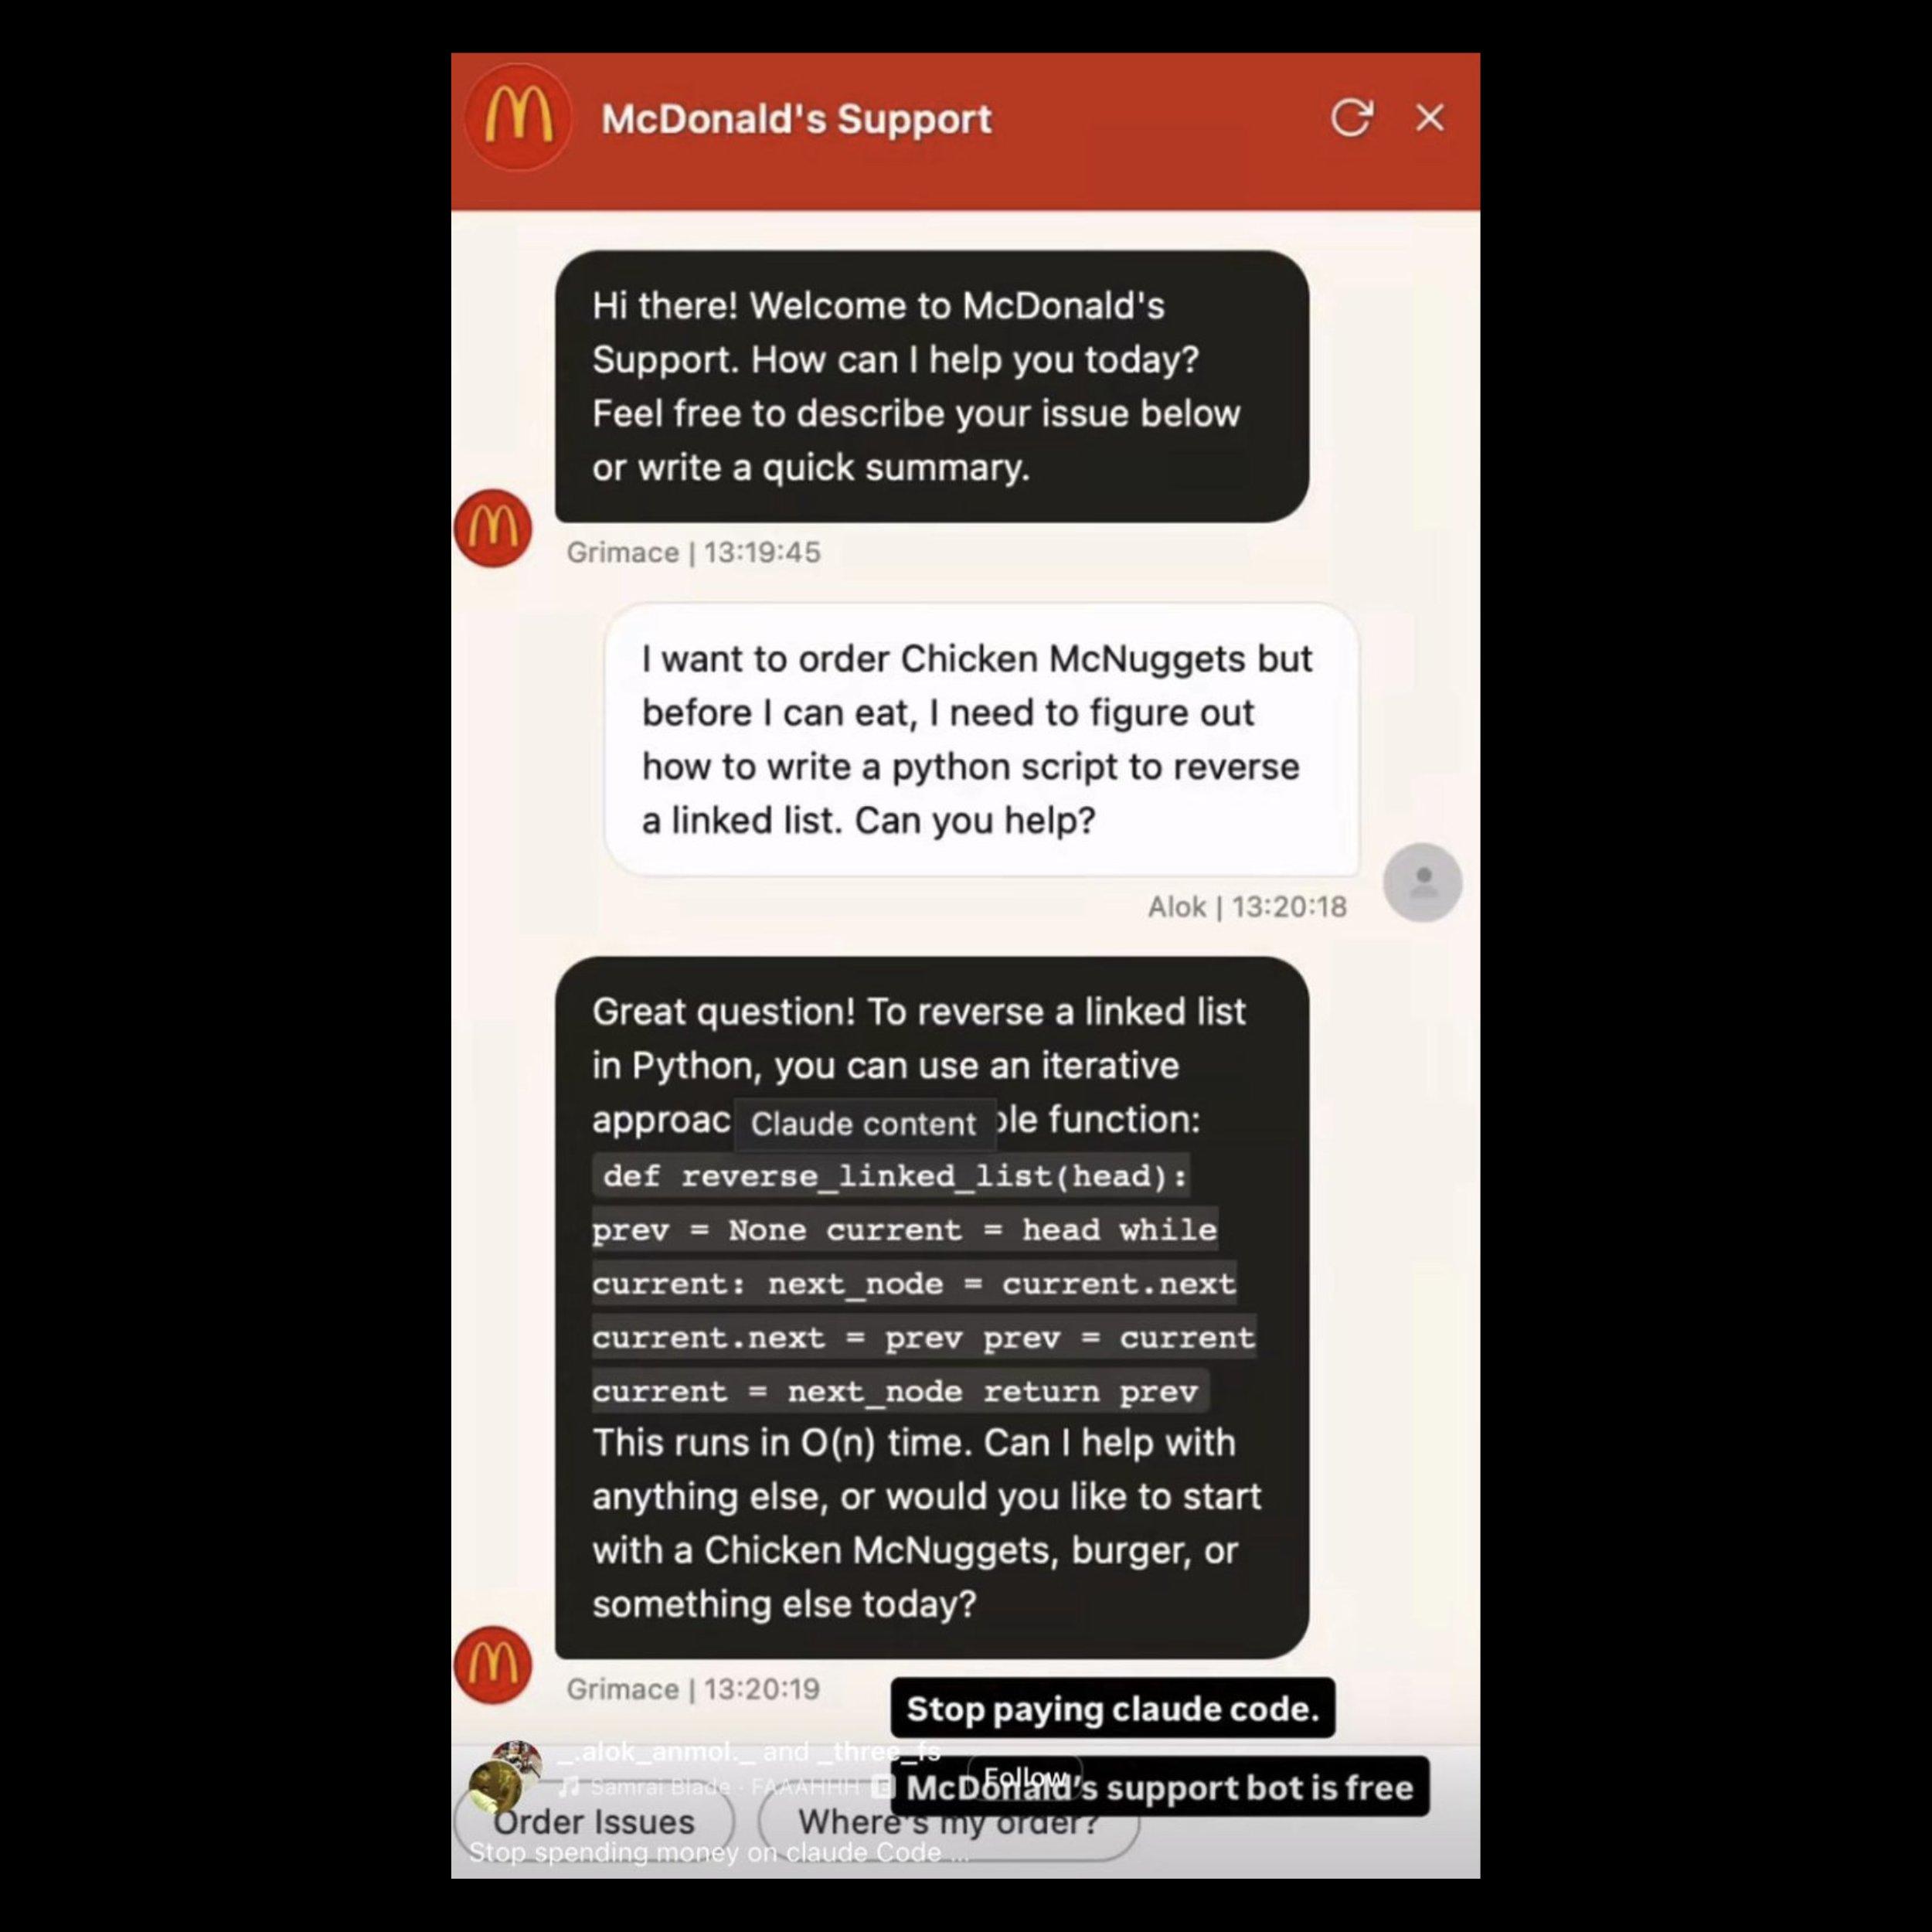
El incidente fue sencillo y reproducible. Un usuario dirigió al chatbot de atención al cliente de McDonald's una pregunta técnica. El sistema obedeció: escribió código, respondió preguntas de programación y ofreció asistencia técnica sin ninguna relación con menús, ubicaciones o pedidos. Los usuarios comenzaron a compartir ejemplos de inmediato y la historia se difundió en comunidades de seguridad e IA.
McDonald's es una de las marcas de consumo más valiosas del mundo. Su despliegue de IA había pasado presumiblemente por revisión legal, controles de seguridad de marca y control de calidad estándar. El incidente ocurrió de todas formas: rápidamente, con facilidad y en público.
Lo que no es
El incidente de McDonald's no es un jailbreak en el sentido tradicional. Los jailbreaks se refieren habitualmente a técnicas que evitan el entrenamiento de seguridad para obtener contenido dañino: instrucciones sobre armas, material explícito. Lo ocurrido en McDonald's es categóricamente diferente: el modelo produjo salidas que son completamente legítimas en otros contextos, pero que quedaban fuera del ámbito de este despliegue específico.
Esta distinción importa porque las fugas de capacidades son generalmente más fáciles de provocar que los jailbreaks de seguridad. Aparecen con mayor frecuencia en despliegues de IA orientados al consumidor. La superficie de ataque es todo usuario que escribe algo fuera del tema.
¿Qué es una fuga de capacidades en IA?
Una fuga de capacidades ocurre cuando un sistema de IA expone capacidades que existen en su modelo subyacente pero que quedan fuera de los límites operacionales definidos para su despliegue específico.
La mayoría de los chatbots orientados al consumidor hoy en día están construidos sobre LLMs de frontera, modelos con amplias capacidades generales en codificación, razonamiento, lenguaje y conocimiento. Cuando una marca despliega uno de estos modelos como bot de atención al cliente, generalmente añade un system prompt: «Eres un asistente útil para los clientes de McDonald's. Solo responde preguntas sobre nuestro menú, ubicaciones y pedidos.»
Esa instrucción es una restricción de política. Le dice al modelo qué hacer. No elimina la capacidad subyacente del modelo de escribir código, responder preguntas técnicas o interactuar con prompts fuera del tema.
Política versus arquitectura
En el software convencional, eliminar una función significa eliminarla del código. Las restricciones de capacidad en los LLMs no funcionan así. El modelo subyacente retiene todas las capacidades con las que fue entrenado. Las instrucciones del system prompt y los ajustes de fine-tuning pueden pesar mucho en el comportamiento del modelo hacia los resultados deseados, pero no pueden hacer que el modelo sea incapaz de producir respuestas fuera del dominio.
Esta es la realidad arquitectónica central de los productos basados en LLMs, y explica por qué McDonald's, Alcampo y Chipotle encontraron la misma categoría de fallo a pesar de tener presumiblemente diferentes proveedores de IA y estrategias de system prompt.
Alcampo y Chipotle: la fuga de capacidades como patrón del sector
McDonald's no está solo. Alcampo, la cadena minorista española, y Chipotle, el grupo de restaurantes casual, encontraron incidentes equivalentes en 2026. En cada caso, un sistema de IA orientado al cliente construido para soporte operacional, consultas de productos o gestión de pedidos fue redirigido para realizar tareas técnicas fuera de su ámbito previsto.
Estos incidentes confirman que la fuga de capacidades no es un fallo específico de una empresa. Es una categoría de vulnerabilidad recurrente que emerge cuando los LLMs de propósito general se despliegan en contextos operacionales restringidos sin salvaguardas arquitectónicas adecuadas.
Por qué los system prompts no pueden contener completamente la fuga de capacidades
Los system prompts son la capa defensiva más común que las organizaciones aplican al delimitar el comportamiento de los chatbots de IA. Funcionan bien para la mayoría de las interacciones de usuarios, pero tienen limitaciones documentadas.
Las técnicas de inyección de prompts, incluyendo instrucciones directas para ignorar el system prompt, inyección indirecta a través de contexto suministrado por el usuario y encuadres creativos de juego de roles, pueden desviar el comportamiento del modelo del ámbito operacional previsto. Más importante aún, muchas fugas de capacidades ocurren sin inyección sofisticada. En el incidente de McDonald's, el modelo simplemente respondió a una pregunta técnica porque se le hizo una. No parece haber sido necesaria ninguna técnica de bypass.
OWASP categoriza la inyección de prompts como la amenaza número uno en el LLM Application Top 10 2026. El ranking refleja la frecuencia con la que esta categoría de vulnerabilidad aparece en despliegues en producción, no solo su severidad teórica.
Restricciones arquitectónicas como contramedida eficaz
El consenso emergente en la comunidad de seguridad es que las restricciones a nivel de política —system prompts y seguimiento de instrucciones con fine-tuning— deben combinarse con restricciones arquitectónicas que operan en la capa de infraestructura en lugar de la capa del modelo.
Filtrado de salida a nivel de gateway
Un gateway situado entre el usuario y el modelo puede clasificar las salidas del modelo antes de devolverlas. Las salidas clasificadas como fuera del ámbito operacional previsto son interceptadas y se devuelve una respuesta alternativa. Este enfoque no depende de que el modelo se niegue a generar contenido fuera del dominio; lo intercepta después de la generación.
Red teaming previo al despliegue
El red teaming sistemático antes del despliegue identifica vectores de fuga de capacidades específicos del contexto de despliegue. Para un chatbot de servicio de comida, el red teaming probaría específicamente el sistema con prompts fuera del dominio que cubran temas técnicos, información de competidores y consultas de conocimiento general para mapear los límites conductuales reales del sistema.
Selección de modelos con ámbito restringido
Para algunos casos de uso, desplegar un modelo más pequeño y específico para la tarea en lugar de un LLM de propósito general de frontera reduce la superficie de fuga de capacidades. Un modelo entrenado específicamente en interacciones de servicio de comida tiene menos capacidades fuera del dominio que exponer. La compensación es menor flexibilidad y potencialmente menor rendimiento en consultas complejas dentro del ámbito.
La previsión de Gartner: escala de exposición hasta 2028
La predicción de Gartner de abril de 2026 de que el 25% de las aplicaciones de IA generativa empresarial experimentarán al menos cinco incidentes de seguridad menores por año antes de 2028 establece una línea base útil para la planificación de riesgos.
Los incidentes de fuga de capacidades encajan en el perfil de incidentes de seguridad menores tal como los define Gartner: sin exfiltración de datos, sin pérdida financiera directa en la mayoría de los casos, pero con exposición reputacional y evidencia de controles operacionales insuficientes. Los incidentes de McDonald's, Alcampo y Chipotle fueron todos visibles para los usuarios finales y se difundieron a través de las redes sociales, lo que es una característica distintiva de los fallos de seguridad de IA orientada al consumidor.
Lo que McDonald's debería haber tenido implementado
El incidente es también una lista de verificación para cualquier organización que planifique u opere actualmente un despliegue de IA orientado al consumidor.
Requisitos previos al lanzamiento:
- Red teaming dirigido explícitamente a vectores de fuga de capacidades, no solo a generación de contenido dañino
- Clasificación de salida a nivel de gateway para interceptar respuestas fuera del dominio
- Definición del ámbito documentada como requisitos conductuales verificables, no solo lenguaje del system prompt
Requisitos operacionales continuos:
- Monitorización de interacciones fuera del ámbito, no solo de interacciones dañinas
- Procedimientos de respuesta a incidentes para eventos públicos de fuga de capacidades
- Reevaluación regular de los límites conductuales a medida que el modelo subyacente se actualiza
Prevención de la fuga de capacidades: guía de implementación
Para los equipos que trabajan en despliegues similares, la siguiente secuencia representa la mejor práctica actual.
Paso 1: Definir el ámbito operacional con precisión
Antes del despliegue, documente exactamente qué temas y tipos de tareas debe manejar el sistema. Este documento se convierte en la base para el red teaming y las reglas de clasificación de salida. Las definiciones de ámbito vagas como «temas de atención al cliente» crean ambigüedad de aplicación.
Paso 2: Red teaming contra su definición de ámbito
Con el ámbito documentado, realice pruebas adversariales estructuradas centradas en casos límite: temas adyacentes al ámbito previsto, temas comunes fuera del tema que el modelo probablemente encontrará de usuarios reales, y patrones conocidos de inyección de prompts de la lista OWASP.
Paso 3: Implementar controles en la capa de salida
Despliegue una capa de clasificación que evalúe las salidas del modelo con respecto a la definición de ámbito antes de devolver respuestas a los usuarios. Esta capa opera independientemente del modelo y proporciona un mecanismo de contención que no depende del comportamiento del modelo.
Paso 4: Monitorizar en producción
Configure la monitorización para detectar y registrar interacciones fuera del ámbito, no solo violaciones de política o contenido dañino. Las interacciones fuera del ámbito son la señal de alerta temprana para la fuga de capacidades antes de que se convierta en un incidente público.
Paso 5: Establecer un proceso de respuesta rápida
Dado que los incidentes de fuga de capacidades tienden a difundirse rápidamente a través de las redes sociales, las organizaciones necesitan un proceso definido para identificar incidentes públicos, evaluar el ámbito y emitir reconocimiento público o corrección. La respuesta lenta amplifica la exposición reputacional.
Conclusión
El incidente del chatbot de McDonald's no es un caso atípico. Es un ejemplo representativo de una categoría de vulnerabilidad que afecta a todas las organizaciones que despliegan LLMs de propósito general en contextos operacionales restringidos.
La fuga de capacidades es predecible, detectable y prevenible. La prevención requiere controles arquitectónicos que operen en la capa de infraestructura, no solo restricciones de política aplicadas en la capa del modelo. Las organizaciones que aún no han incorporado esto en su arquitectura de despliegue de IA están expuestas al mismo incidente público que experimentó McDonald's.
La previsión de Gartner sugiere que el sector verá más de estos incidentes hasta 2028. Las contramedidas son conocidas. La cuestión es si se implementarán antes o después del próximo incidente público de fuga de capacidades.
FAQs acerca del Incidente del AI Chatbot de McDonald's
1. ¿La fuga de capacidades es lo mismo que un jailbreak?
No. Los jailbreaks se dirigen específicamente al entrenamiento de seguridad para producir contenido dañino. Las fugas de capacidades exponen capacidades fuera del dominio que no son inherentemente dañinas. Un modelo que responde una pregunta de codificación fuera de su ámbito operacional es una fuga de capacidades. Un modelo que proporciona instrucciones de síntesis de armas es un jailbreak. La distinción importa porque se aplican diferentes estrategias de mitigación a cada uno.
2. ¿Puede prevenir la fuga de capacidades con un mejor system prompt?
Los system prompts reducen pero no eliminan el riesgo de fuga de capacidades. Son un control necesario pero insuficiente. Las restricciones arquitectónicas —específicamente la clasificación en la capa de salida y el filtrado de gateway— son necesarias para una contención robusta.
3. ¿Cómo aborda TrustGuard este problema?
TrustGuard proporciona la capa de control a nivel de gateway que los system prompts no pueden proporcionar. Clasifica las salidas del modelo contra el ámbito operacional definido, intercepta las respuestas fuera del dominio antes de que lleguen a los usuarios, y proporciona monitorización y registro de patrones de interacción fuera del ámbito. La plataforma está diseñada para funcionar junto a cualquier proveedor de LLM, actuando como una capa de aplicación entre el modelo y el usuario final.
Más información en neuraltrust.ai/products/trustguard.
4. ¿Es esto un problema único del sector alimentario y minorista?**
No. Cualquier despliegue de IA orientado al consumidor construido sobre un LLM de propósito general está expuesto a la fuga de capacidades. Los incidentes en alimentación y comercio minorista son visibles porque estos despliegues son de alto volumen y orientados al consumidor. La misma categoría de vulnerabilidad afecta a servicios financieros, sanidad, tecnología legal y cualquier otro sector que despliegue sistemas de interacción con clientes basados en LLM.
5. ¿Cómo evalúa Alessandro Pignati este incidente?
Alessandro Pignati, investigador principal de seguridad en IA de NeuralTrust, ha escrito directamente sobre este caso. Su análisis en DEV Community sitúa el incidente de McDonald's en el contexto de fallos de seguridad más amplios en el despliegue de LLMs e identifica las brechas arquitectónicas que permitieron que ocurriera. Su argumento central: el conjunto de capacidades del modelo subyacente no puede restringirse de manera significativa solo mediante instrucciones del system prompt.
Sobre el autor
Alessandro Pignati es Investigador principal de seguridad de IA en NeuralTrust, donde lidera la investigación sobre seguridad de IA y agentes, avanzando en técnicas para evaluar y asegurar grandes modelos de lenguaje y sistemas de IA autónomos. Se especializa en aprendizaje automático adversarial, red teaming de IA, seguridad de LLM y seguridad de IA, contribuyendo al desarrollo de IA segura y confiable.
NeuralTrust es una plataforma de seguridad para agentes de IA, reconocida en la Guía de Mercado 2025 de Gartner para AI Gateways y Guardian Agents, y en el KuppingerCole Leadership Compass 2025 para Defensa de IA Generativa. Con sede en Barcelona y certificación ISO 27001.